
Контекст і терміни
Noindex — це директива для пошукових систем: «не показуй цю URL у результатах». Найчастіше її передають через <meta name="robots" content="noindex"> або заголовок X-Robots-Tag. Важливо: сторінку все одно можна відкрити в браузері й навіть просканувати — просто вона не повинна з’являтися в SERP.
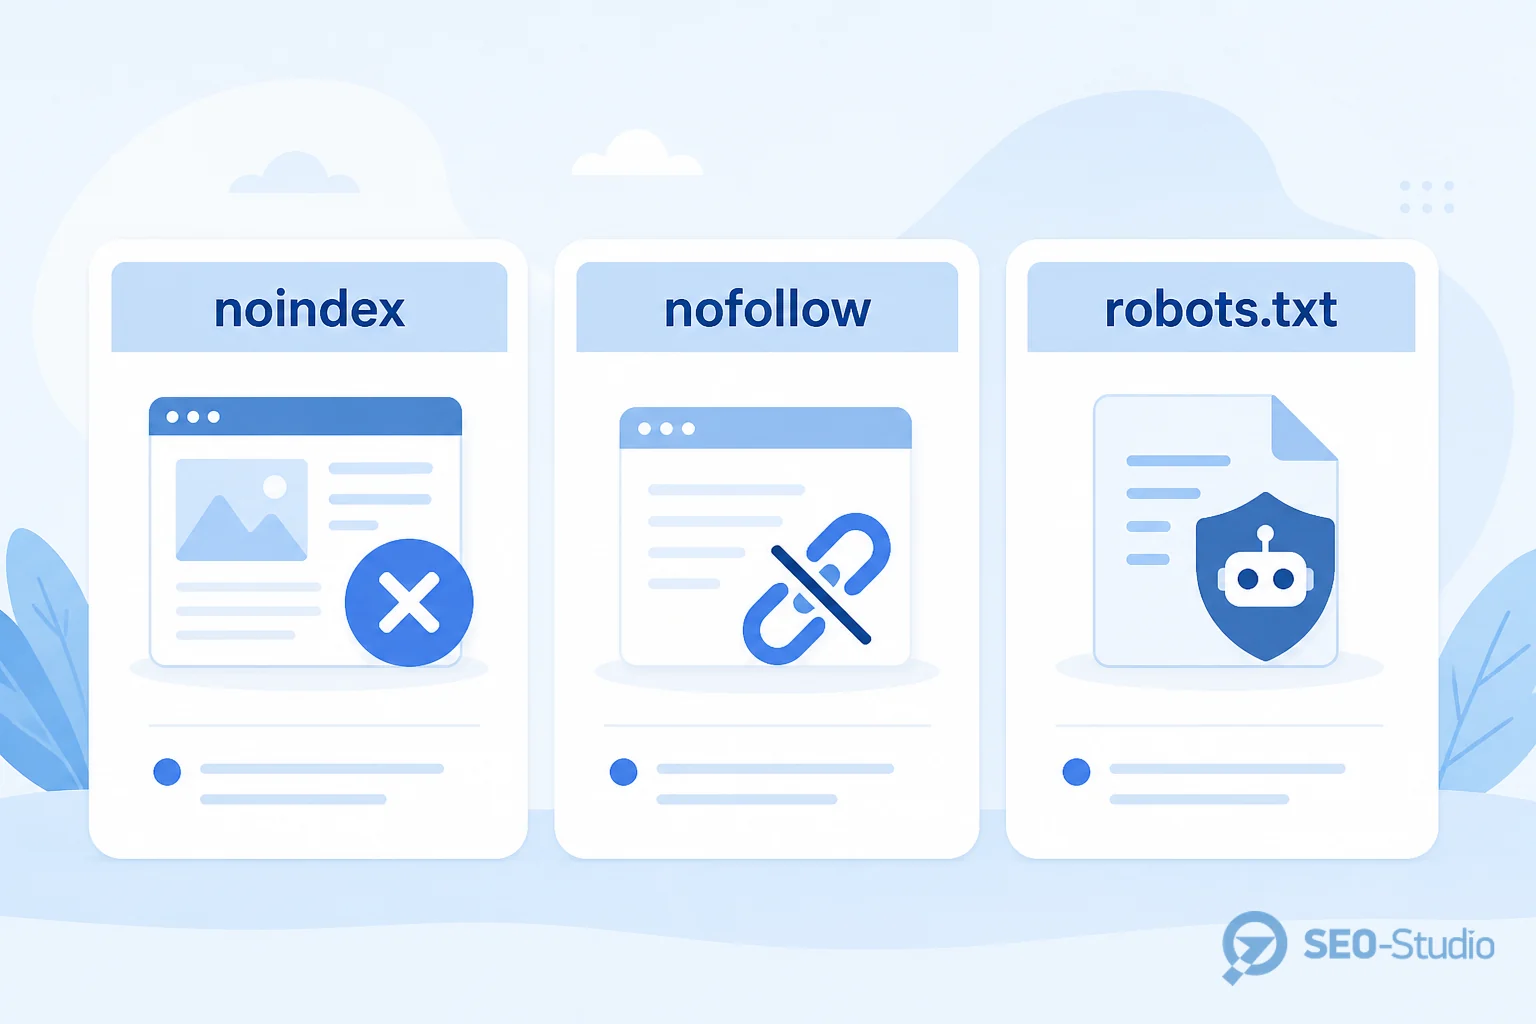
Поруч часто плутають три інструменти:
- noindex — прибрати (або не пускати) URL з індексу.
- nofollow — сигнал не передавати «вагу» за посиланням; на індексацію цільової сторінки впливає слабко.
- robots.txt Disallow — заборона сканування. Якщо бот не бачить HTML, він може й не побачити noindex усередині.
Практичний висновок: щоб надійно вивести сторінку з видачі, Google має побачити noindex. Закривати такі URL у robots.txt «на всяк випадок» — типова помилка.
Crawl budget (бюджет обходу) — це скільки URL Google реально встигає й хоче сканувати на вашому хості. Noindex і бюджет обходу пов’язані, але це різні важелі:
- noindex чистить індекс (SERP), але бот усе одно має зайти на сторінку, щоб прочитати директиву — тобто обхід вона часто продовжує «з’їдати»;
- robots.txt Disallow ріже сканування, але тоді noindex у HTML уже не спрацює надійно;
- щоб і з індексу прибрати, і менше палити crawl budget, потрібна зв’язка: noindex + менше внутрішніх лінків на сміттєві URL + нормальні статус-коди для мертвих сторінок (404/410), а не лише «поставили noindex і забули».
Що зробити на практиці
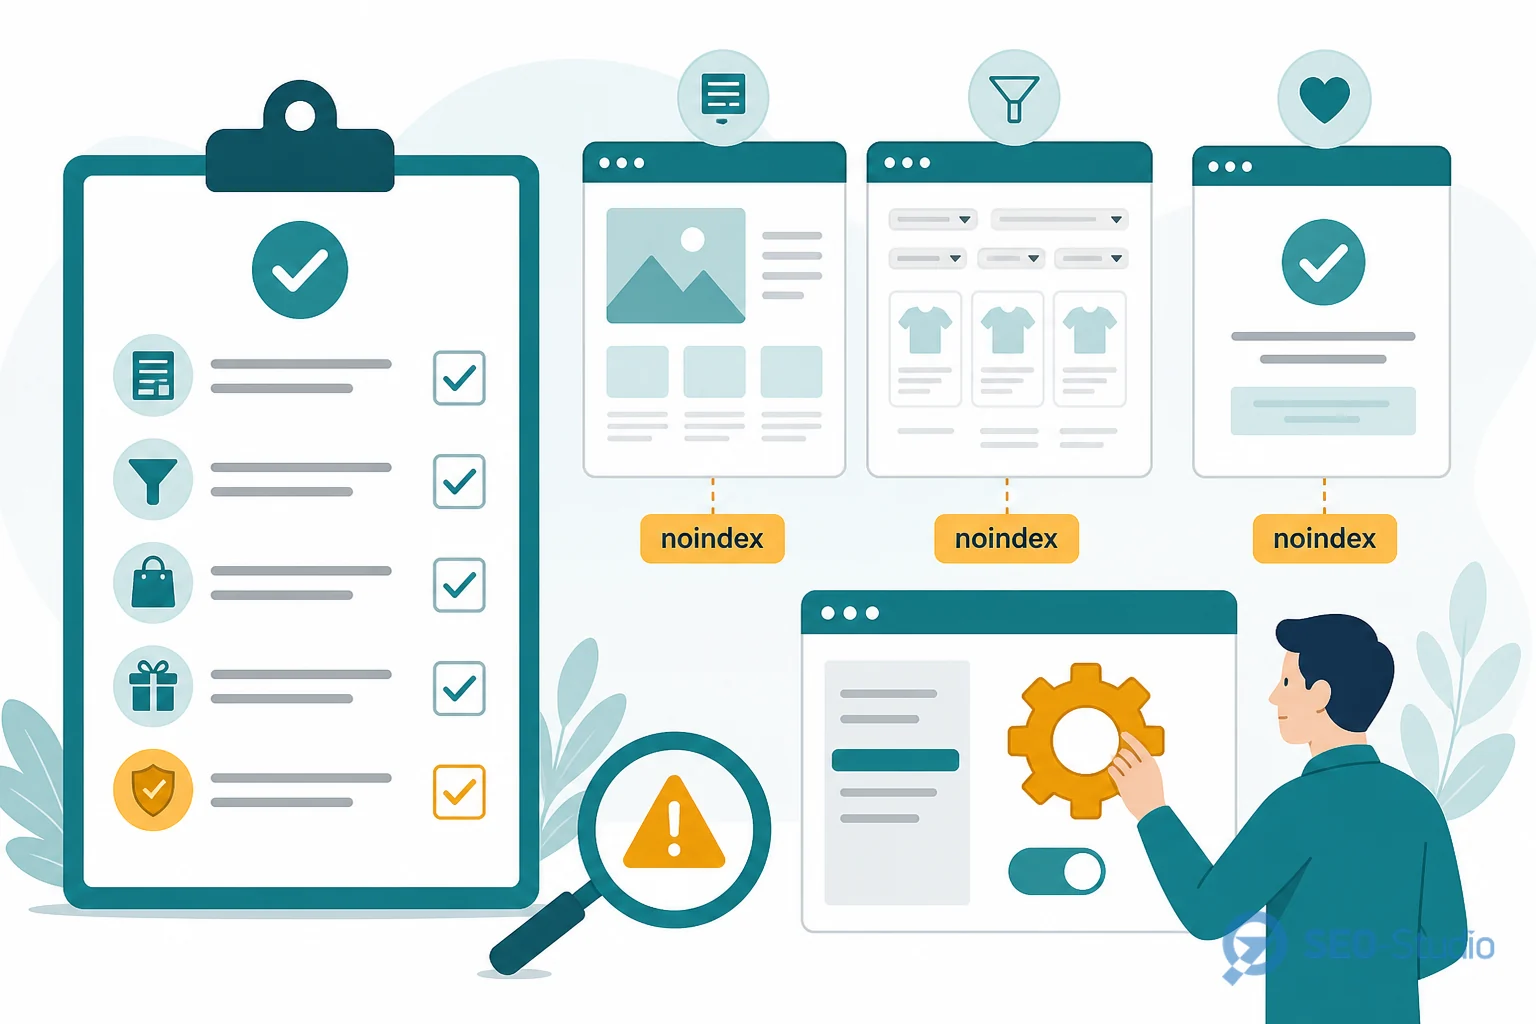
Ставте noindex там, де сторінка потрібна користувачу або системі, але не повинна змагатися в органіці:
- службові URL: кошик, кабінет, подяка за заявку, пошук по сайту;
- тонкий або шаблонний контент без унікальної цінності;
- дублі й «шумні» параметри: сортування, зайві фільтри, UTM-версії як окремі канонічні адреси;
- технічні/тестові середовища, якщо вони раптом відкриті ззовні.
Не ставте noindex на сторінки, з яких ви хочете трафік і ліди: категорії, ключові послуги, сильні статті, комерційні лендінги. Якщо сторінка слабка — краще доробити контент, канонікал або об’єднати URL, а не «сховати проблему» директивою.
Якщо мета ще й заощадити crawl budget (великий каталог, фасети, параметри):
- приберіть або скоротіть внутрішні посилання на noindex-URL з шаблонів, хедера, футера й «схожих товарів» — інакше бот знову й знову витрачатиме квоту на них;
- для остаточно мертвих сторінок віддавайте 404/410 замість «вічного» 200 + noindex;
- параметри фільтрів краще контролювати через канонікал / параметр-хендлінг у GSC і архітектуру URL, а не сипати noindex на тисячі комбінацій, на які все ще ведуть лінки;
- sitemap залишайте лише для URL, які мають бути в індексі — noindex-сторінки туди не додавайте.
Перед масовим впровадженням зафіксуйте список шаблонів і відповідального: хто додає noindex у CMS, хто перевіряє після релізу.
Типові помилки та ризики
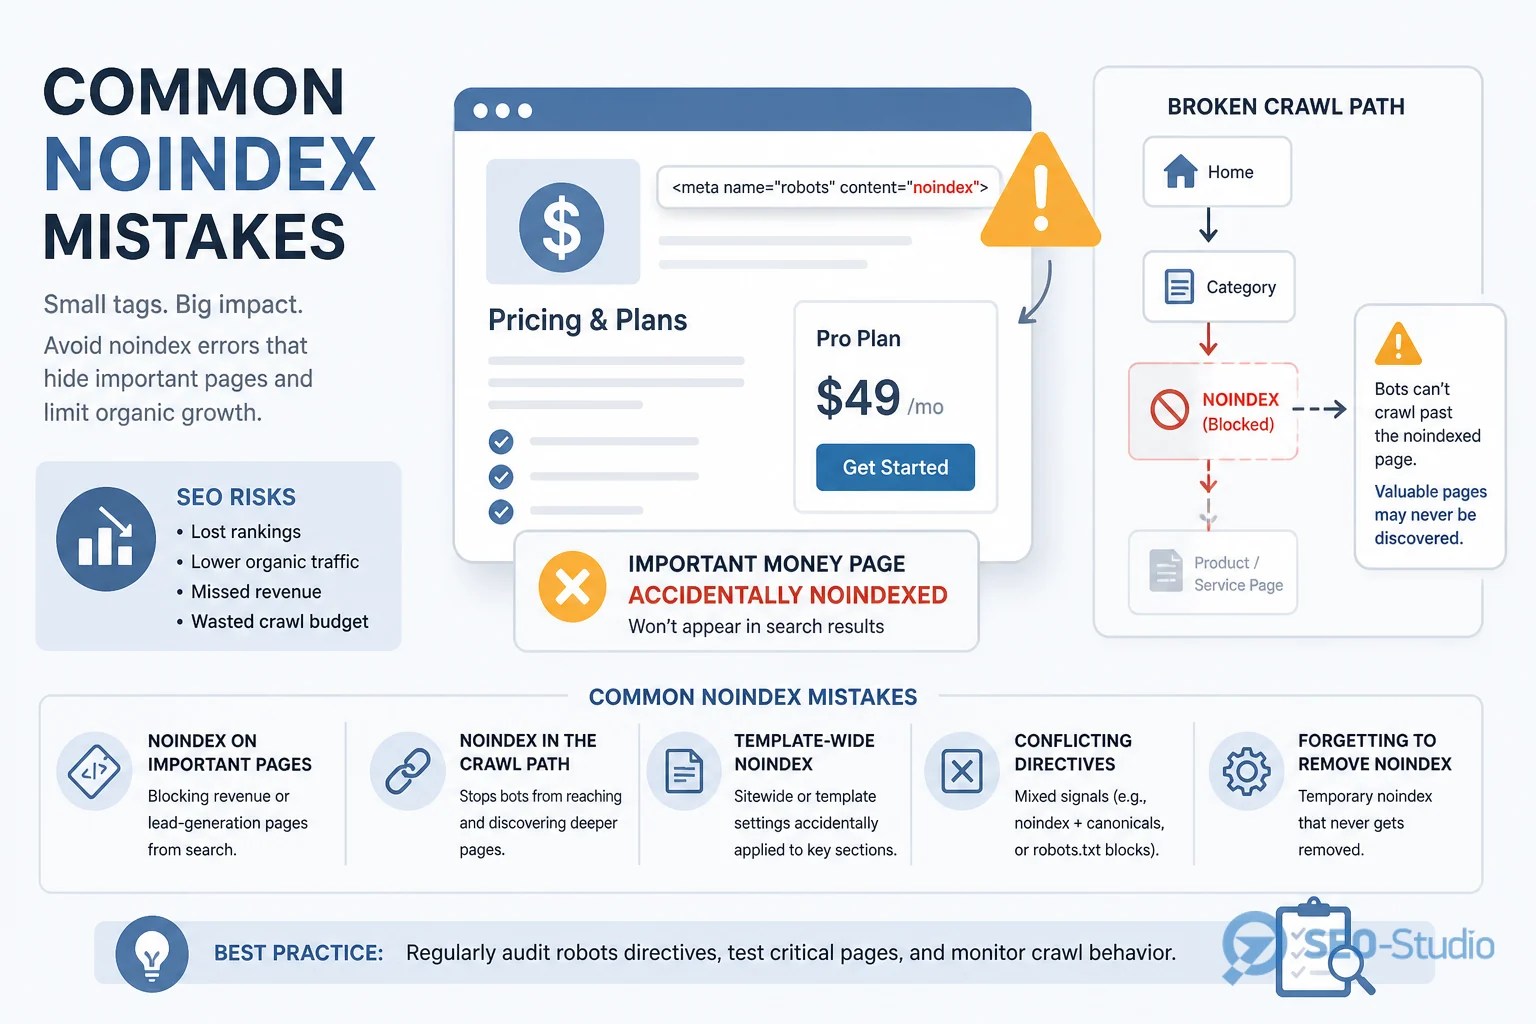
Найчастіші провали в проєктах:
- глобальний noindex у шаблоні «на час розробки», який забули зняти на проді;
- плагін SEO виставив noindex для цілого типу записів або пагінації без аудиту;
- noindex + Disallow в robots.txt — директиву не видно, статус у звітах «заплутаний»;
- міф «поставили noindex — зберегли crawl budget»: за великої перелінковки бот далі палить обхід на ті самі URL;
- noindex замість нормального
rel="canonical"на дублях, які варто склеїти; - закрили пагінацію чи фільтри так, що з індексу зникли й корисні посадкові з тих самих шаблонів.
Ризик вимірюється грошима: одна випадково закрита категорія може зняти органіку швидше, ніж ви встигнете помітити падіння в аналітиці. Окремий ризик для великих сайтів — роздутий обхід сміттєвих noindex-URL замість свіжих грошових сторінок.
Як перевірити результат
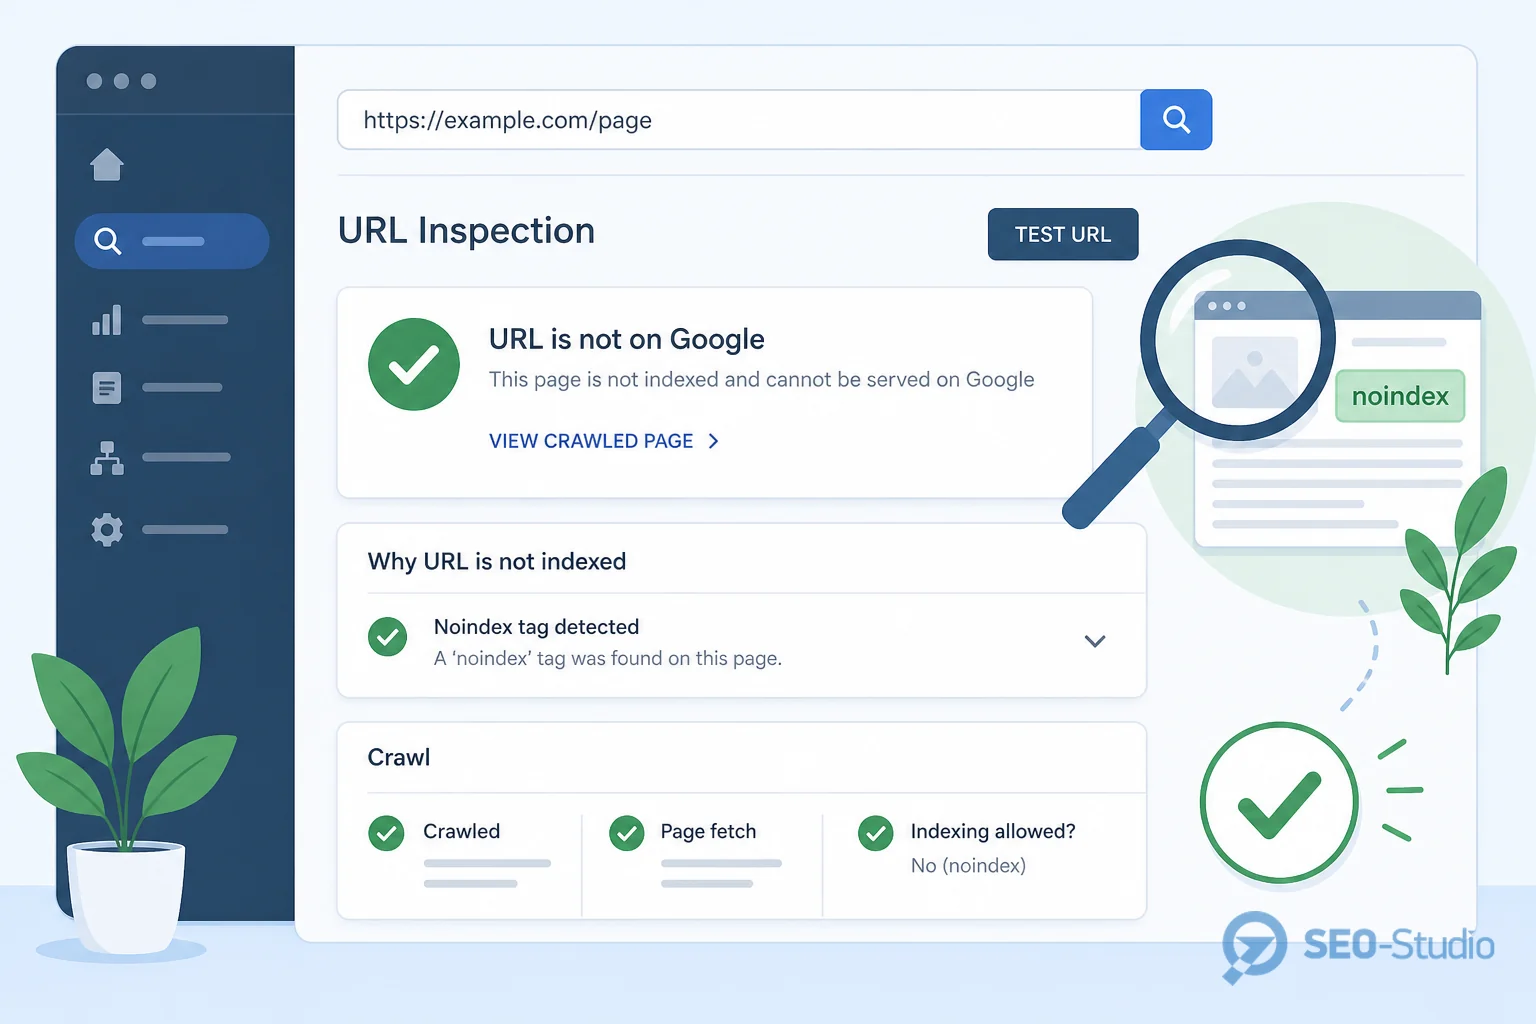
Короткий регламент після будь-якої зміни noindex:
- Відкрийте URL без кешу, перегляньте код: чи є meta robots / X-Robots-Tag саме з noindex.
- Переконайтеся, що URL не Disallow в robots.txt — інакше перевірка індексації буде неповною.
- У Google Search Console: перевірка URL → запит індексації для контрольних сторінок; далі дивіться «Сторінки» / покриття.
- Збережіть зріз: які URL мають лишитися в індексі, які — випасти. Через 1–2 цикли обходу звірте факт.
- Для бюджету обходу: у звітах сканування / статистиці краулінгу подивіться, чи не домінують службові й параметричні URL; порівняйте частку «проскановано, але не проіндексовано» до і після чистки лінків.
- Для грошових шаблонів тримайте окремий чекліст «ніколи noindex» у реліз-процесі.
Якщо сторінка досі в видачі за site: або у звіті «проіндексовано» — директива не дістається боту, кеш ще старий, або ви дивитесь не той хост/мову.
Висновок
Noindex — точний інструмент гігієни індексу, а не «кнопка SEO» і не заміна управлінню crawl budget. Він доречний для службових, тонких і дубльованих URL і шкідливий, коли ховає сторінки з попитом. Щоб прибрати URL з видачі і не зливати обхід на сміття, поєднуйте noindex з архітектурою посилань і статус-кодами. Правило просте: бот має прочитати директиву, команда — мати список винятків, а після релізу — перевірку в HTML і Search Console.