
Контекст і терміни
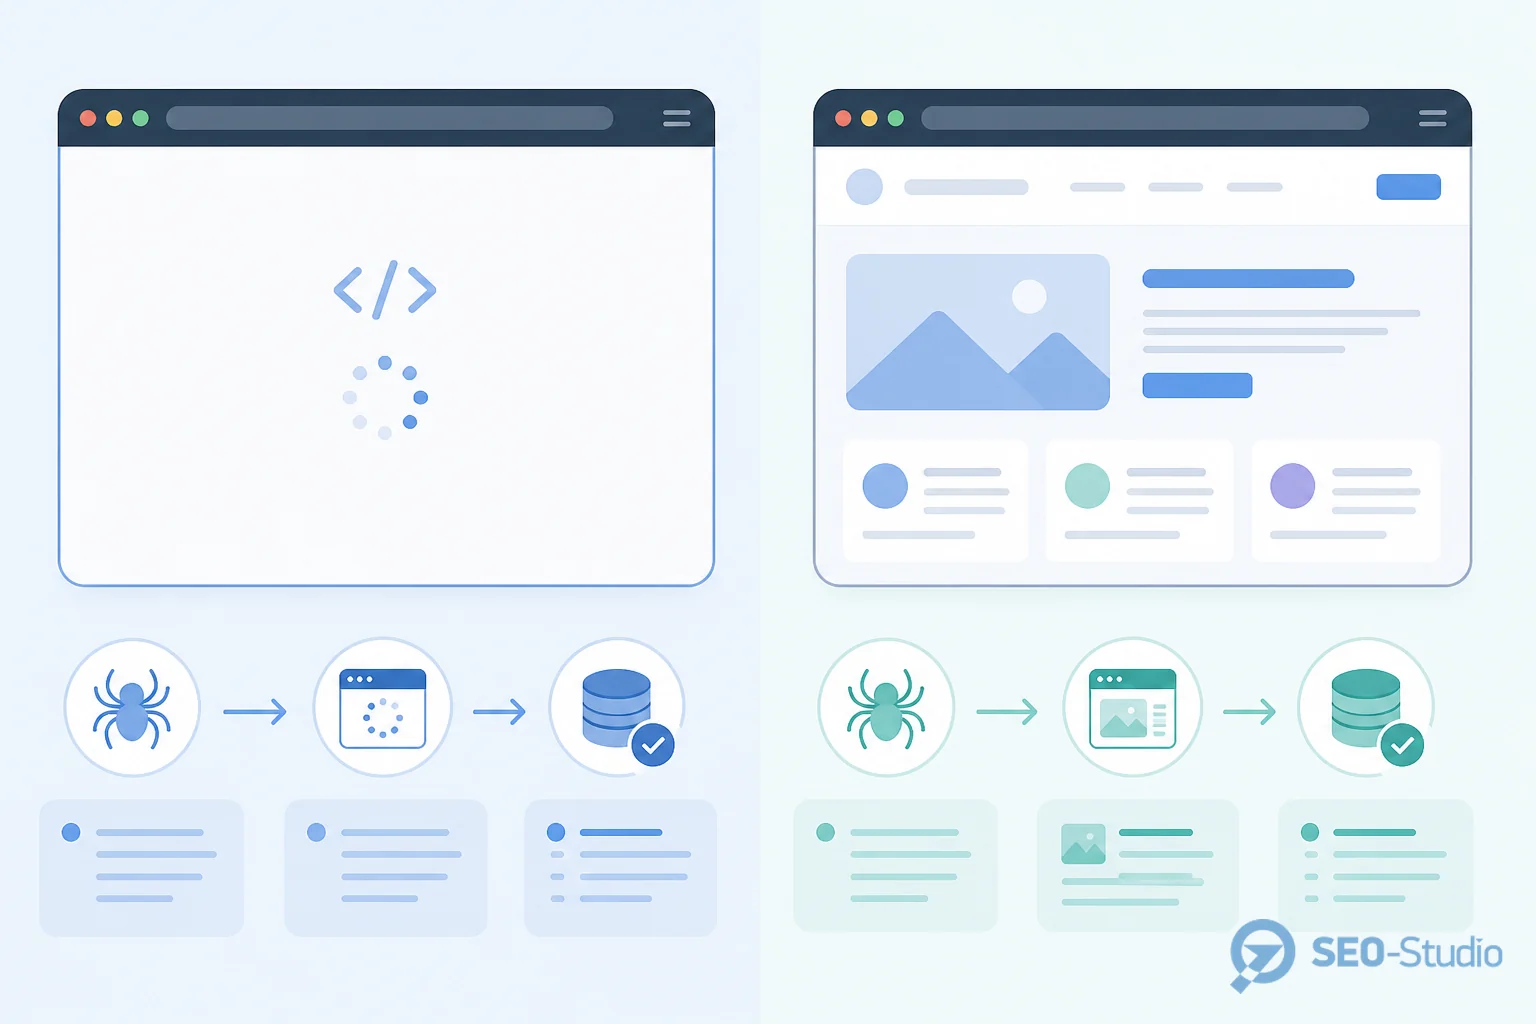
Google не «бачить» React/Vue/Angular так, як користувач у браузері. Спочатку краулер отримує HTML-відповідь сервера, ставить URL у чергу на рендер (Web Rendering Service), виконує JavaScript і лише потім вирішує, що індексувати. Якщо важливий текст, ціни чи посилання з’являються тільки після довгого клієнтського рендеру — індексація може запізнитися або взагалі не відбутися.
Корисні терміни для діагностики:
- CSR (client-side rendering) — сервер віддає майже порожній каркас, контент збирає JS у браузері.
- SSR / SSG / hydration — HTML уже містить основний контент; JS лише «оживлює» інтерфейс. Для SEO це зазвичай безпечніший шлях.
- Rendered HTML — HTML після виконання JS у WRS. Саме його треба порівнювати з тим, що бачить користувач.
- Soft 404 — сервер відповідає 200, але після рендеру сторінка виглядає порожньою або як «не знайдено». Google часто не індексує такі URL.
- Crawl budget на ресурси — якщо robots.txt або CDN блокують JS/CSS, рендер ламається навіть при коректному роутингу.
Search Console тут — основний джерело правди: не «чи відкривається сайт у Chrome», а «що саме Google зміг відрендерити й проіндексувати».
Що зробити на практиці
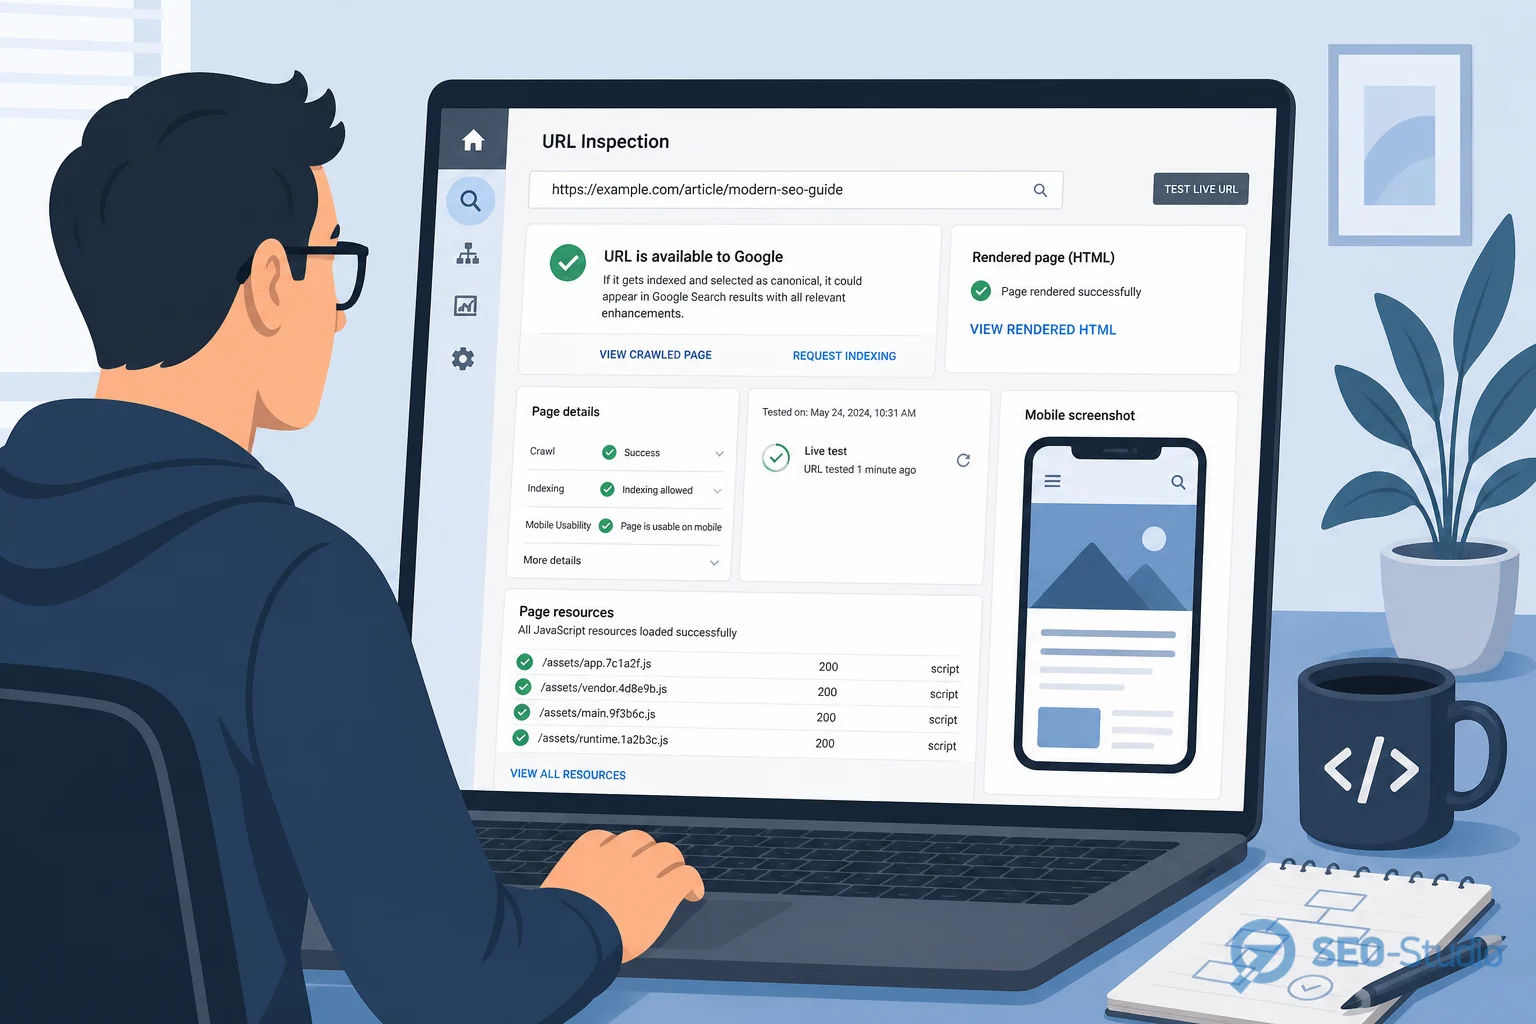
Пройдіть еталонні URL (головна, категорія, товар/послуга, блог-пост, 404) через Перевірка URL у Google Search Console.
- Відкрийте Переглянуту сторінку (або Live test) і порівняйте HTML з тим, що очікуєте: чи є H1, основний текст, ціна, внутрішні посилання.
- Подивіться скріншот: порожній екран, спінер без контенту або «заглушка» — сигнал, що рендер не встиг або JS не відпрацював.
- У блоці завантажених ресурсів перевірте, чи немає заблокованих критичних
.js/.css. - Звірте canonical, title і meta robots у відрендереному HTML — SPA інколи підставляє їх занадто пізно.
- Для пагінації та фільтрів у SPA переконайтеся, що кожен потрібний стан має окремий crawlable URL (історія History API + серверний fallback), а не лише hash-роутинг.
Паралельно в коді/інфраструктурі:
- Не блокуйте в
robots.txtшляхи зі статикою фреймворку (/_next/,/static/, бандли Vite/Webpack). - Віддавайте ключовий контент у першій HTML-відповіді (SSR/SSG або prerender для ботів).
- Для API-даних, без яких немає тексту сторінки, зменшуйте час до first meaningful content: критичні запити — на сервері або з коротким timeout-friendly шляхом.
- Налаштуйте коректні HTTP-статуси для неіснуючих SPA-маршрутів (справжній 404, не 200 з «Not found» у JS).
- Sitemap має містити фінальні канонічні URL, а не лише
/з клієнтським роутингом.
Типові помилки та ризики
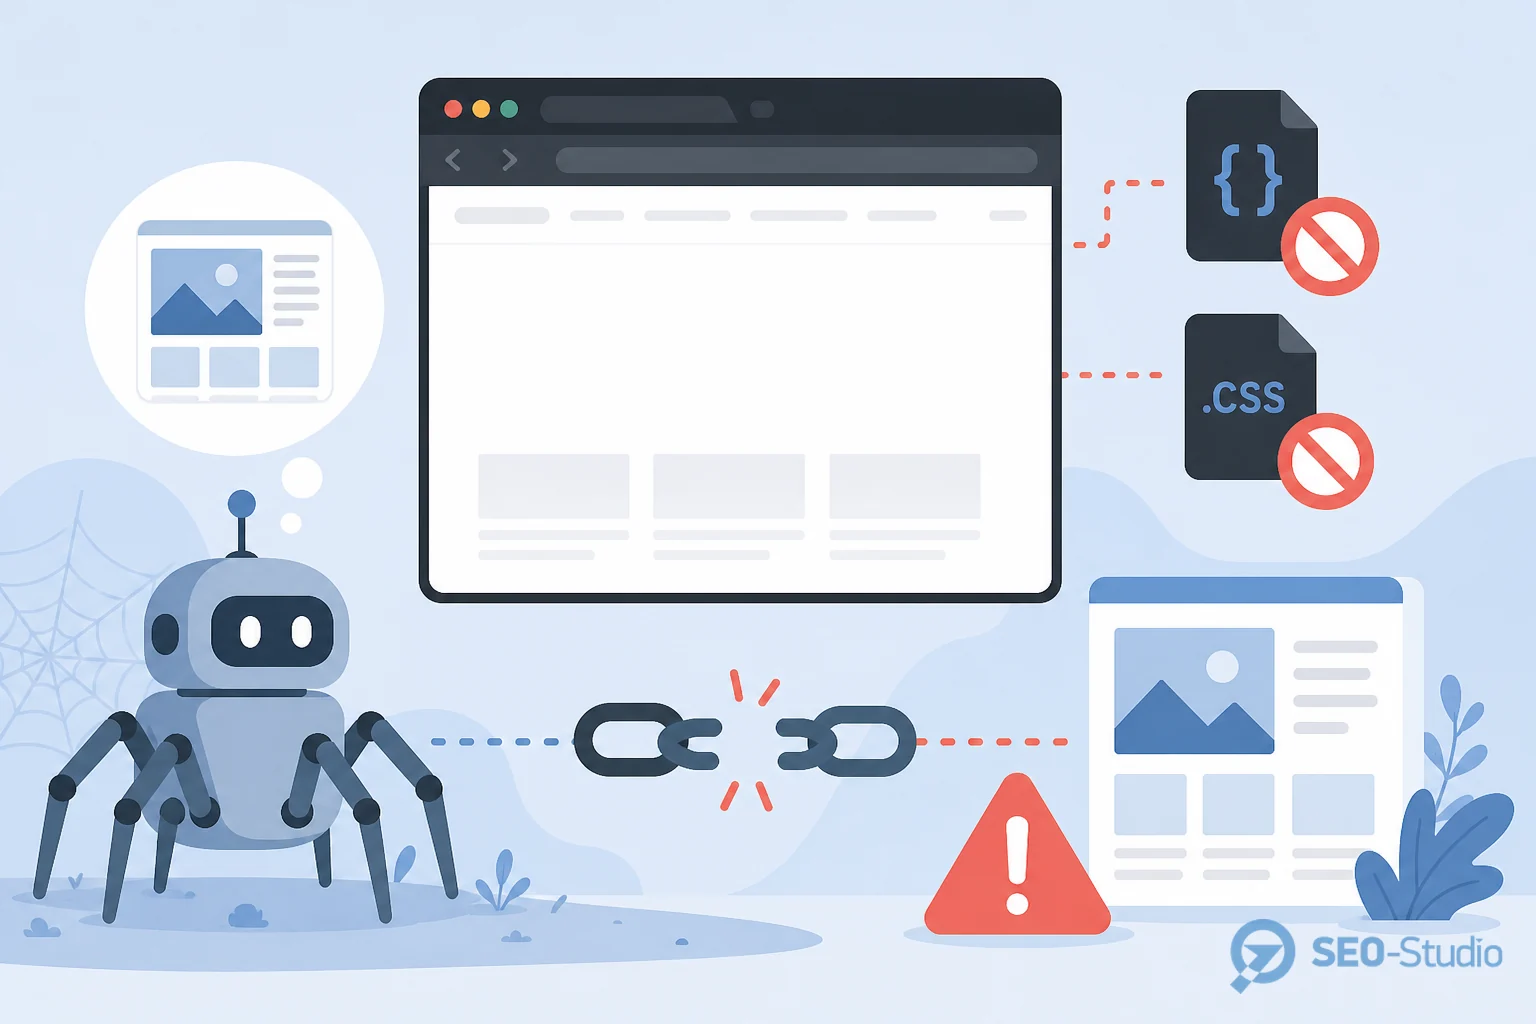
- robots.txt ріже JS/CSS — класика: «сайт у браузері ок», а в GSC — порожній рендер.
- Контент тільки після авторизації або після кліку — бот цього не зробить; індексуватиме порожницю.
- Infinite scroll без URL — глибокі позиції каталогу не потрапляють у обхід.
- Різний контент для User-Agent без узгодженого prerender — ризик cloaking і розсинхрону з Live test.
- Lazy hydration без SSR на грошових лендінгах — title/H1 у індексі є, а комерційний блок «з’являється пізніше» і не стабільно індексується.
- Дубль головної через client routes (
/home,/#/, query-параметри сесій) розмиває сигнали.
Не змінюйте одночасно роутинг, robots.txt і шаблон метаданих: якщо індексація просяде, не зрозумієте, яка зміна винна.
Як перевірити результат
Контрольний чекліст після правок:
- Повторна Перевірка URL (live) на тих самих еталонних сторінках — HTML і скріншот містять основний контент.
- Звіт Page indexing: зменшення «Crawled — currently not indexed» / soft 404 для шаблонів, які виправили.
- Порівняння site: і вибірки з sitemap: нові/оновлені JS-сторінки з’являються в індексі протягом кількох циклів обходу.
- У Coverage / Page indexing немає масових причин на кшталт «Blocked by robots.txt» для статичних бандлів.
- Внутрішня перелінковка з SSR-сторінок веде на канонічні URL SPA, а не на hash-посилання.
Зафіксуйте дату перевірки й список URL у тікеті — через 2–3 тижні легше підтвердити, що регресії після наступного релізу фронту немає.
Висновок
Індексація JavaScript-сайту — це перевірка не «чи працює UI», а чи бачить Google той самий контент після рендеру. Тримайте критичний HTML на сервері або в швидкому prerender, не блокуйте ресурси рендеру, віддавайте чесні статус-коди й регулярно ганяйте еталонні URL через Search Console. Якщо потрібен аудит CSR/SSR, пріоритети для розробки й контроль індексації після релізів — зверніться до команди SEO-Studio.