
Контекст і терміни
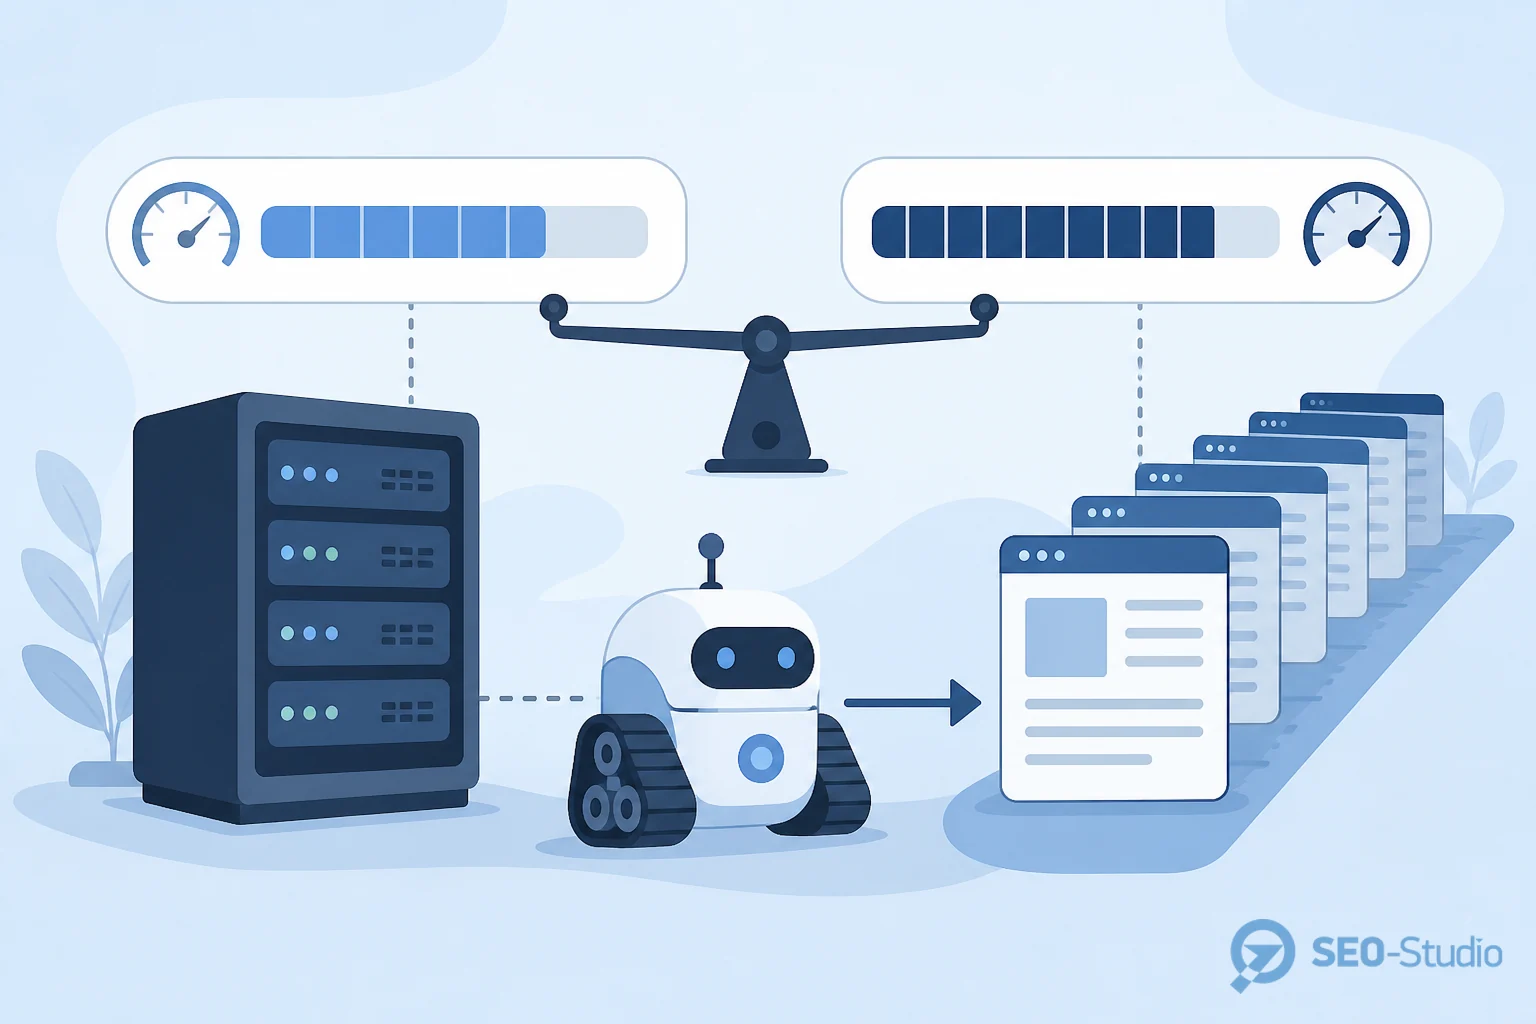
Crawl budget — це практична межа, скільки URL Googlebot готовий і здатен регулярно сканувати на вашому хості. Google описує управління обходом для великих сайтів у Managing crawl budget for large sites. Для маленького сайту з чистою структурою «бюджет» майже не відчутний; для каталогів, фасетів і JS-вітрин він стає вузьким місцем індексації.
Корисні розрізнення:
- Crawl rate / capacity — скільки запитів сервер нормально витримує без помилок і таймаутів.
- Crawl demand — наскільки Google вважає URL важливими (посилання, оновлення, трафік, сигнали якості).
- Індексація ≠ обхід — сторінку можуть просканувати й не проіндексувати; або навпаки довго не заходити на новий URL.
- Noindex ≠ економія бюджету — бот часто все одно заходить, щоб прочитати директиву. Детальніше коли noindex доречний.
Якщо сайт на JavaScript, частина «бюджету» ще йде на ресурси рендеру. Тоді паралельно дивіться індексацію JavaScript-сайтів у Search Console.
Що зробити на практиці
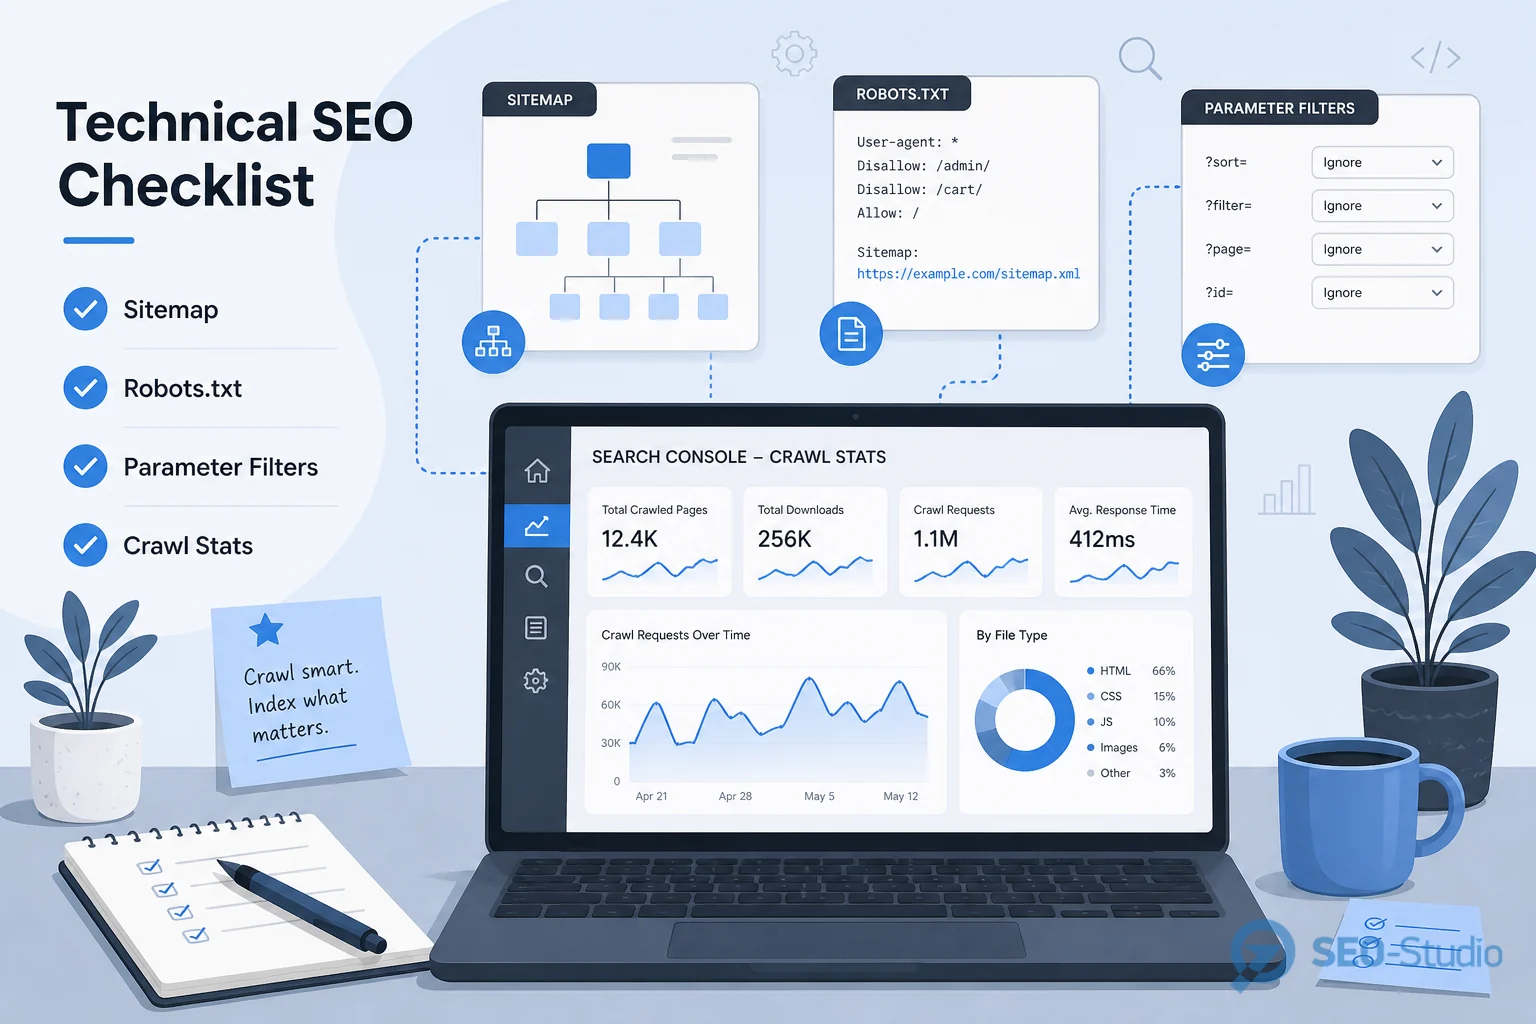
Ціль не «збільшити магічне число», а щоб Google частіше й стабільніше бачив грошові URL.
- Зберіть еталонні URL (головна, топ-категорії, топ-товари/послуги, важливі статті) і прогоніть через URL Inspection.
- Приберіть з внутрішньої перелінковки сміттєві комбінації фільтрів/сортувань або зробіть їх некраулебельними без користі.
- Тримайте XML-карту лише з канонічними URL, які мають бути в індексі; оновлюйте її після великих релізів.
- Перевірте robots.txt не блокує CSS/JS і важливі розділи, але й не відкриває службові без потреби.
- Для мертвих сторінок віддавайте 404/410 замість вічного 200; для тонких службових — noindex + менше лінків, а не «все в Disallow».
- Скоротіть ланцюги редіректів і дублі (www/non-www, trailing slash, HTTP→HTTPS) — кожен зайвий стрибок їсть обхід.
На великих e-commerce робіть окремий backlog «фасети/параметри» з пріоритетом, інакше crawl budget з’їдять комбінації, яких немає в попиті.
Типові помилки та ризики
- Вважати, що noindex сам по собі «звільняє» crawl budget.
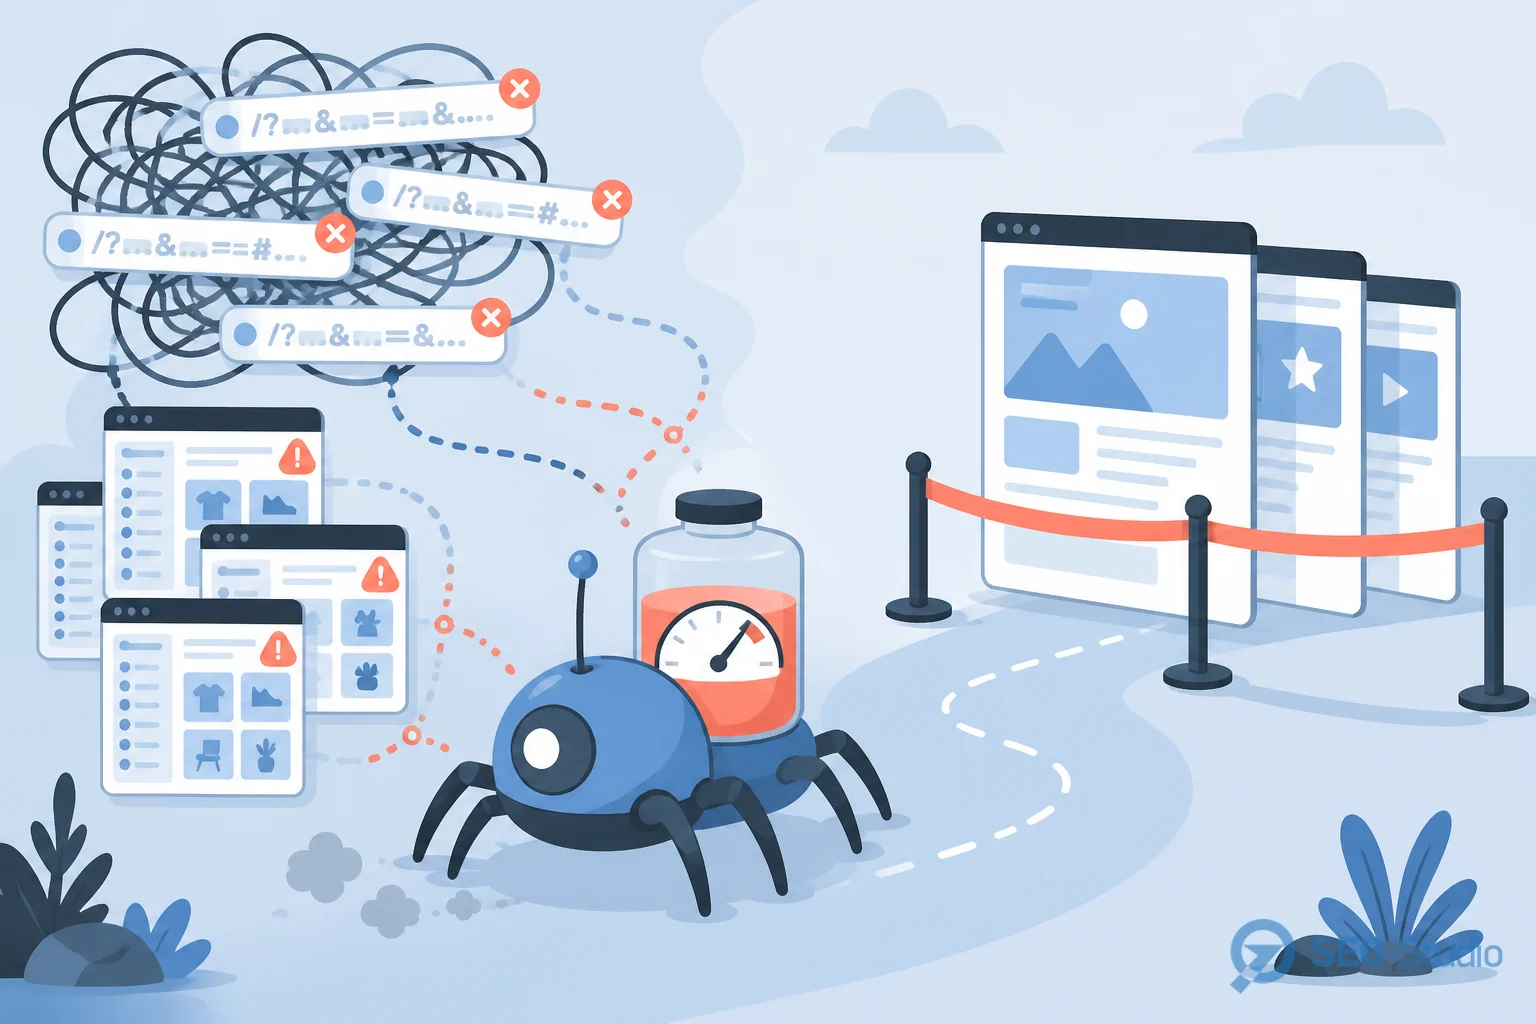
- Закрити в robots.txt те, що треба проіндексувати, або навпаки залишити відкритими тисячі параметричних дублів.
- Sitemap з усім підряд, включно з noindex і редіректами.
- Нескінченна пагінація / calendar archives / теги без користі.
- Повільний TTFB і хвилі 5xx — Google зменшує інтенсивність обходу.
- SPA без нормальних URL і статус-кодів (див. матеріал про JS-індексацію).
Ризик простий. Поки бот жує сміття, свіжі чи комерційні сторінки оновлюються рідше — і ви бачите «просідання» там, де контент нібито «в порядку».
Як перевірити результат
- У Search Console порівняйте статистику сканування до/після. Менше помилок хоста, стабільніший обхід важливих шляхів.
- У Page indexing зменшується частка «проскановано, але не проіндексовано» для сміттєвих шаблонів і зростає покриття цільових.
- Еталонні URL у URL Inspection показують свіжішу дату обходу.
- Логи сервера / CDN. Частка хітів Googlebot на грошові шляхи vs параметри.
- Через 2–4 тижні звірте, чи нові посадкові з sitemap реально потрапляють в індекс без ручного «просить проіндексувати» на кожну.
Висновок
Crawl budget важливий не як абстрактна метрика, а як спосіб не витрачати обхід Google на сміття. Чистіть параметри й дублі, тримайте здорову sitemap, не плутайте noindex з економією сканування й перевіряйте ефект у Search Console. Якщо потрібен аудит великих каталогів і пріоритезація backlog — команда SEO-Studio допоможе з діагностикою та впровадженням.