Контекст и термины
Noindex — директива для поисковых систем: «не показывай этот URL в результатах». Чаще всего её передают через <meta name="robots" content="noindex"> или заголовок X-Robots-Tag. Важно: страницу по-прежнему можно открыть в браузере и даже просканировать — просто она не должна появляться в SERP.
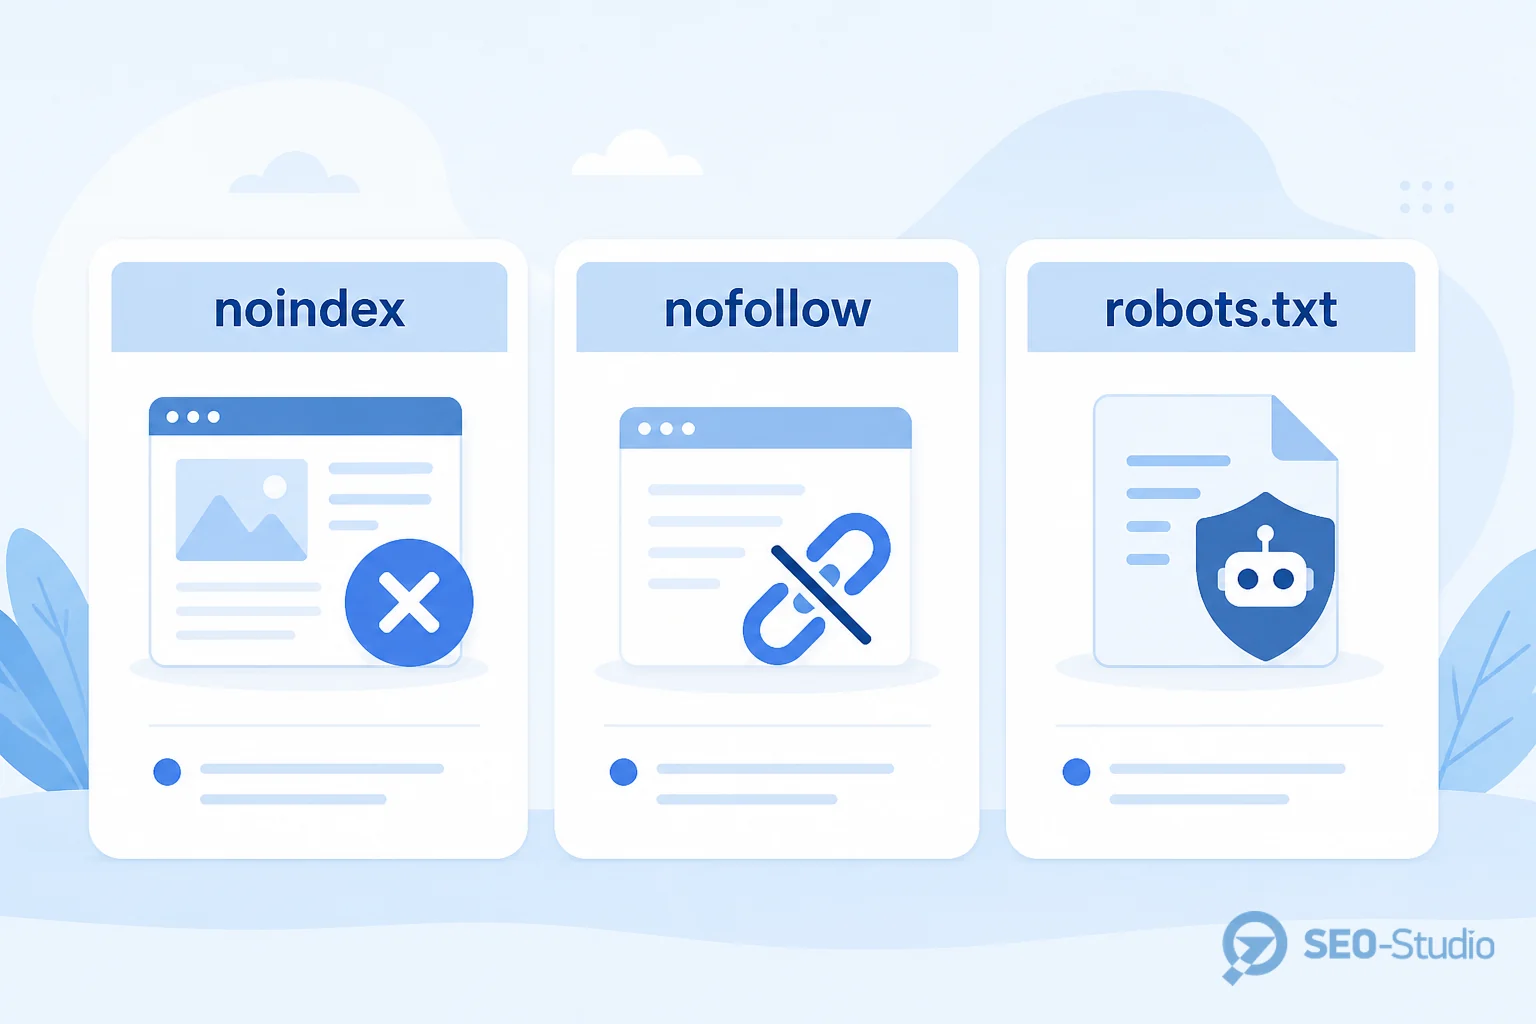
Рядом часто путают три инструмента:
- noindex — убрать (или не пускать) URL из индекса.
- nofollow — сигнал не передавать «вес» по ссылке; на индексацию целевой страницы влияет слабо.
- robots.txt Disallow — запрет сканирования. Если бот не видит HTML, он может и не увидеть noindex внутри.
Практический вывод: чтобы надёжно вывести страницу из выдачи, Google должен увидеть noindex. Закрывать такие URL в robots.txt «на всякий случай» — типичная ошибка.
Crawl budget (бюджет обхода) — сколько URL Google реально успевает и хочет сканировать на вашем хосте. Noindex и бюджет обхода связаны, но это разные рычаги:
- noindex чистит индекс (SERP), но бот всё равно должен зайти на страницу, чтобы прочитать директиву — то есть обход она часто продолжает «съедать»;
- robots.txt Disallow режет сканирование, но тогда noindex в HTML уже не сработает надёжно;
- чтобы и из индекса убрать, и меньше сжигать crawl budget, нужна связка: noindex + меньше внутренних ссылок на мусорные URL + нормальные статус-коды для мёртвых страниц (404/410), а не только «поставили noindex и забыли».
Что делать на практике
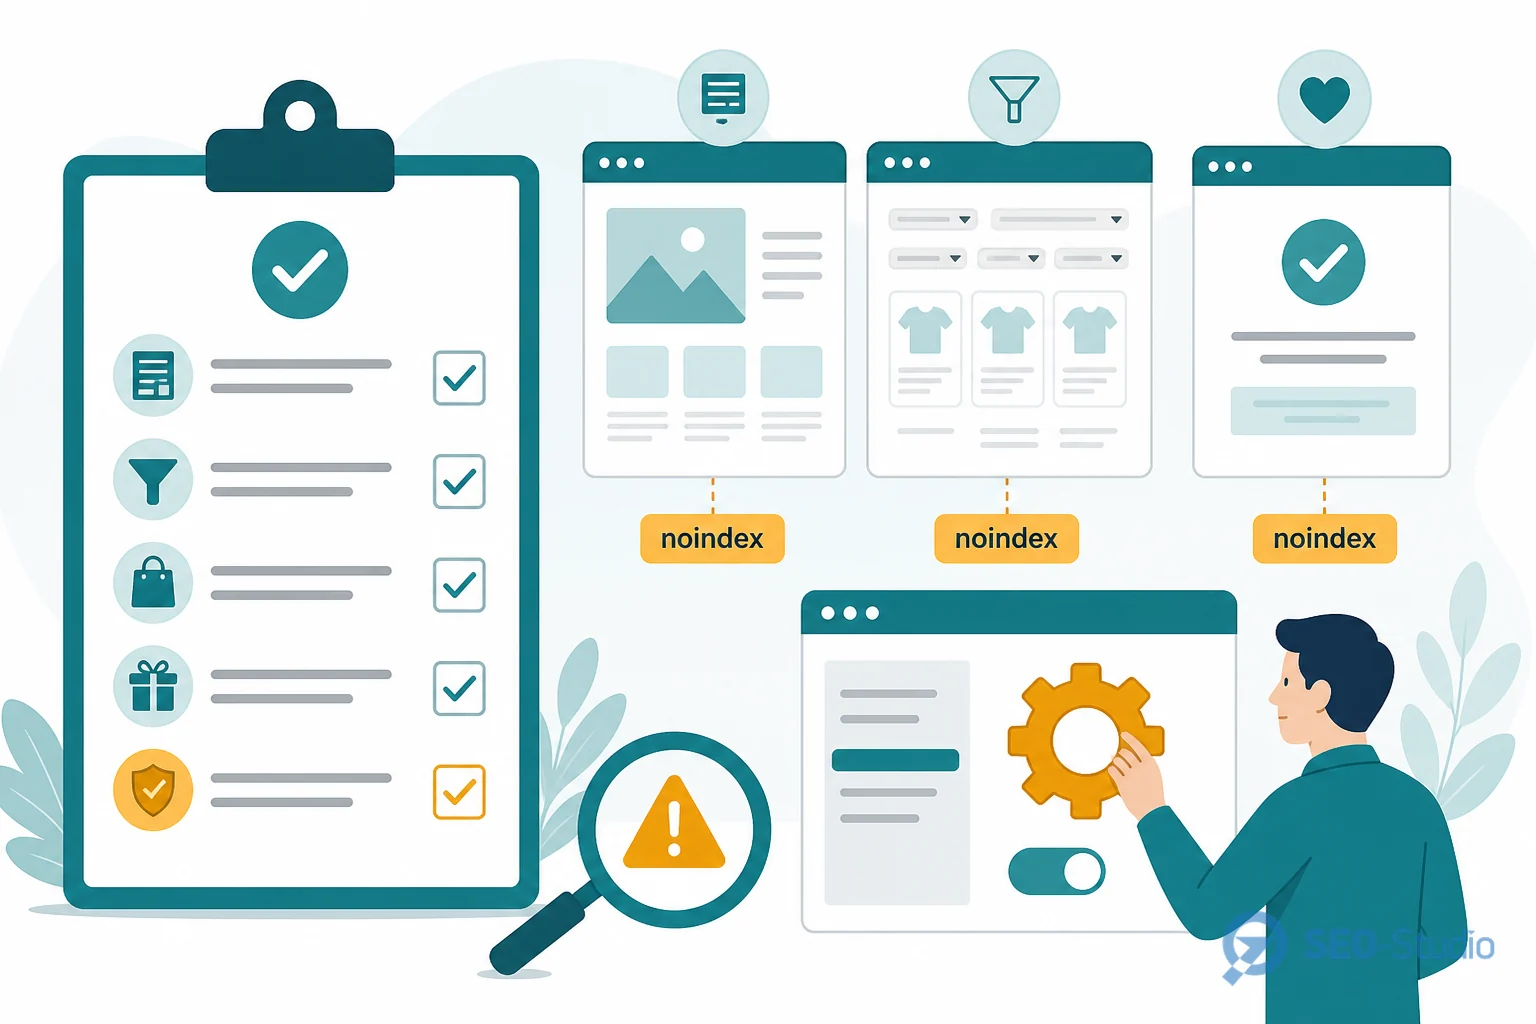
Ставьте noindex там, где страница нужна пользователю или системе, но не должна конкурировать в органике:
- служебные URL: корзина, кабинет, «спасибо за заявку», поиск по сайту;
- тонкий или шаблонный контент без уникальной ценности;
- дубли и «шумные» параметры: сортировки, лишние фильтры, UTM-версии как отдельные канонические адреса;
- технические/тестовые среды, если они вдруг открыты снаружи.
Не ставьте noindex на страницы, с которых вы хотите трафик и лиды: категории, ключевые услуги, сильные статьи, коммерческие лендинги. Если страница слабая — лучше доработать контент, каноникал или объединить URL, а не «спрятать проблему» директивой.
Если цель ещё и сэкономить crawl budget (большой каталог, фасеты, параметры):
- уберите или сократите внутренние ссылки на noindex-URL из шаблонов, хедера, футера и «похожих товаров» — иначе бот снова и снова будет тратить квоту на них;
- для окончательно мёртвых страниц отдавайте 404/410 вместо «вечного» 200 + noindex;
- параметры фильтров лучше контролировать через каноникал / обработку параметров в GSC и архитектуру URL, а не сыпать noindex на тысячи комбинаций, на которые всё ещё ведут ссылки;
- sitemap оставляйте только для URL, которые должны быть в индексе — noindex-страницы туда не добавляйте.
Перед массовым внедрением зафиксируйте список шаблонов и ответственного: кто добавляет noindex в CMS, кто проверяет после релиза.
Типичные ошибки и риски
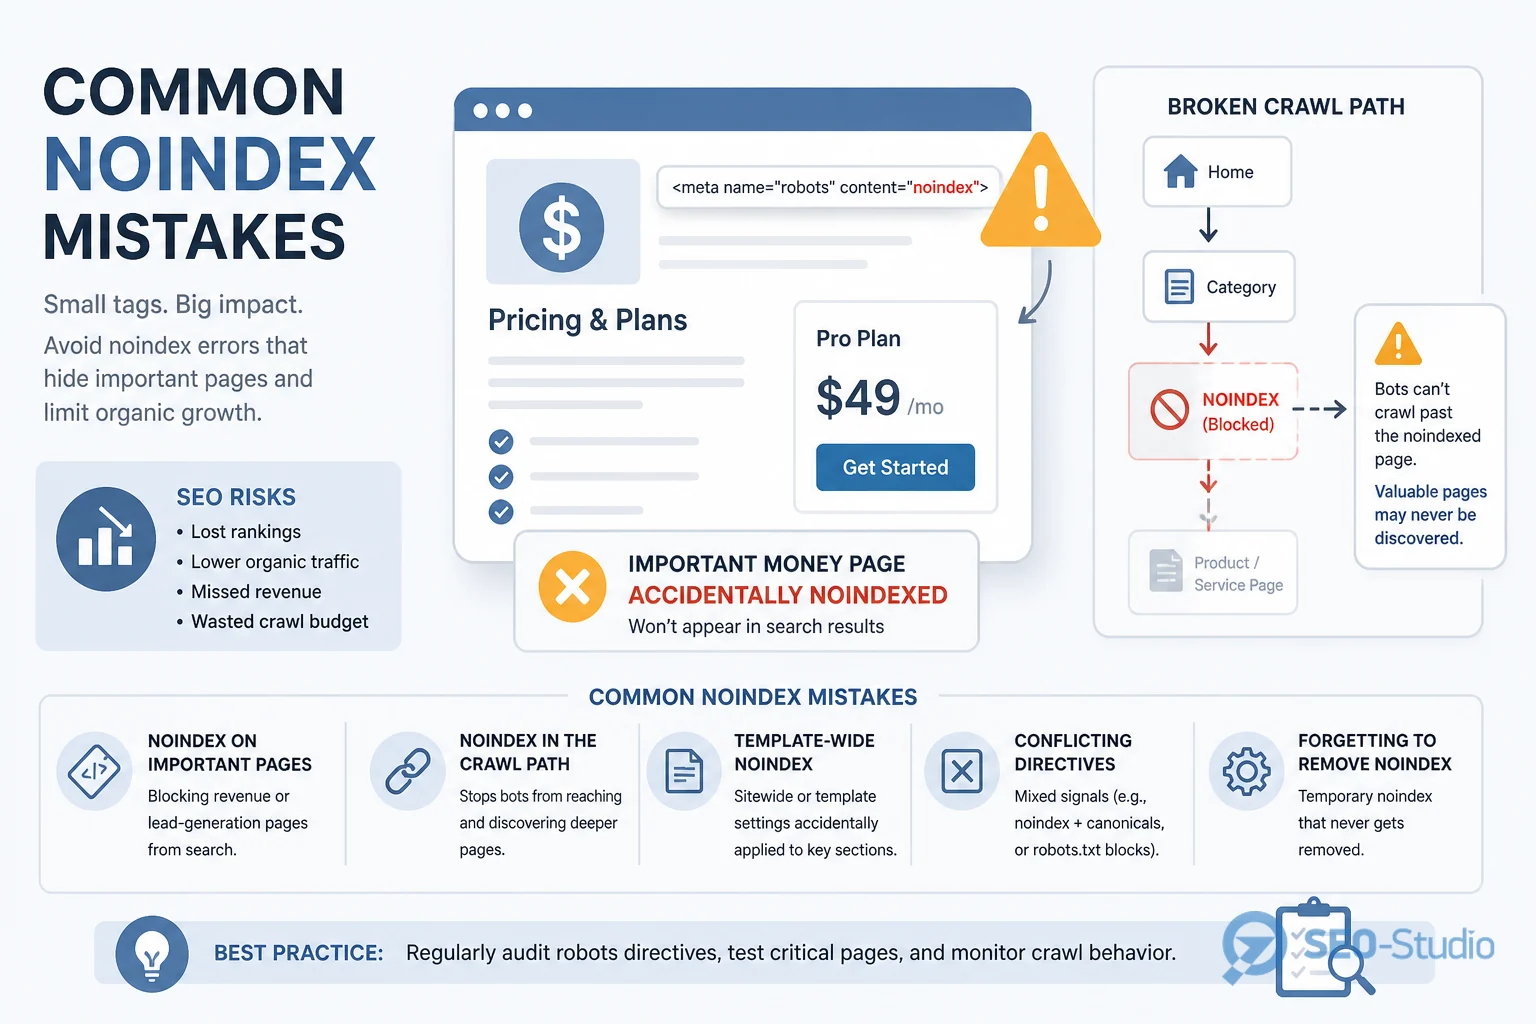
Самые частые провалы в проектах:
- глобальный noindex в шаблоне «на время разработки», который забыли снять на проде;
- SEO-плагин выставил noindex для целого типа записей или пагинации без аудита;
- noindex + Disallow в robots.txt — директиву не видно, статус в отчётах «запутанный»;
- миф «поставили noindex — сохранили crawl budget»: при большой перелинковке бот дальше сжигает обход на те же URL;
- noindex вместо нормального
rel="canonical"на дублях, которые стоит склеить; - закрыли пагинацию или фильтры так, что из индекса пропали и полезные посадочные с тех же шаблонов.
Риск измеряется деньгами: одна случайно закрытая категория может снять органику быстрее, чем вы успеете заметить падение в аналитике. Отдельный риск для больших сайтов — раздутый обход мусорных noindex-URL вместо свежих денежных страниц.
Как проверить результат
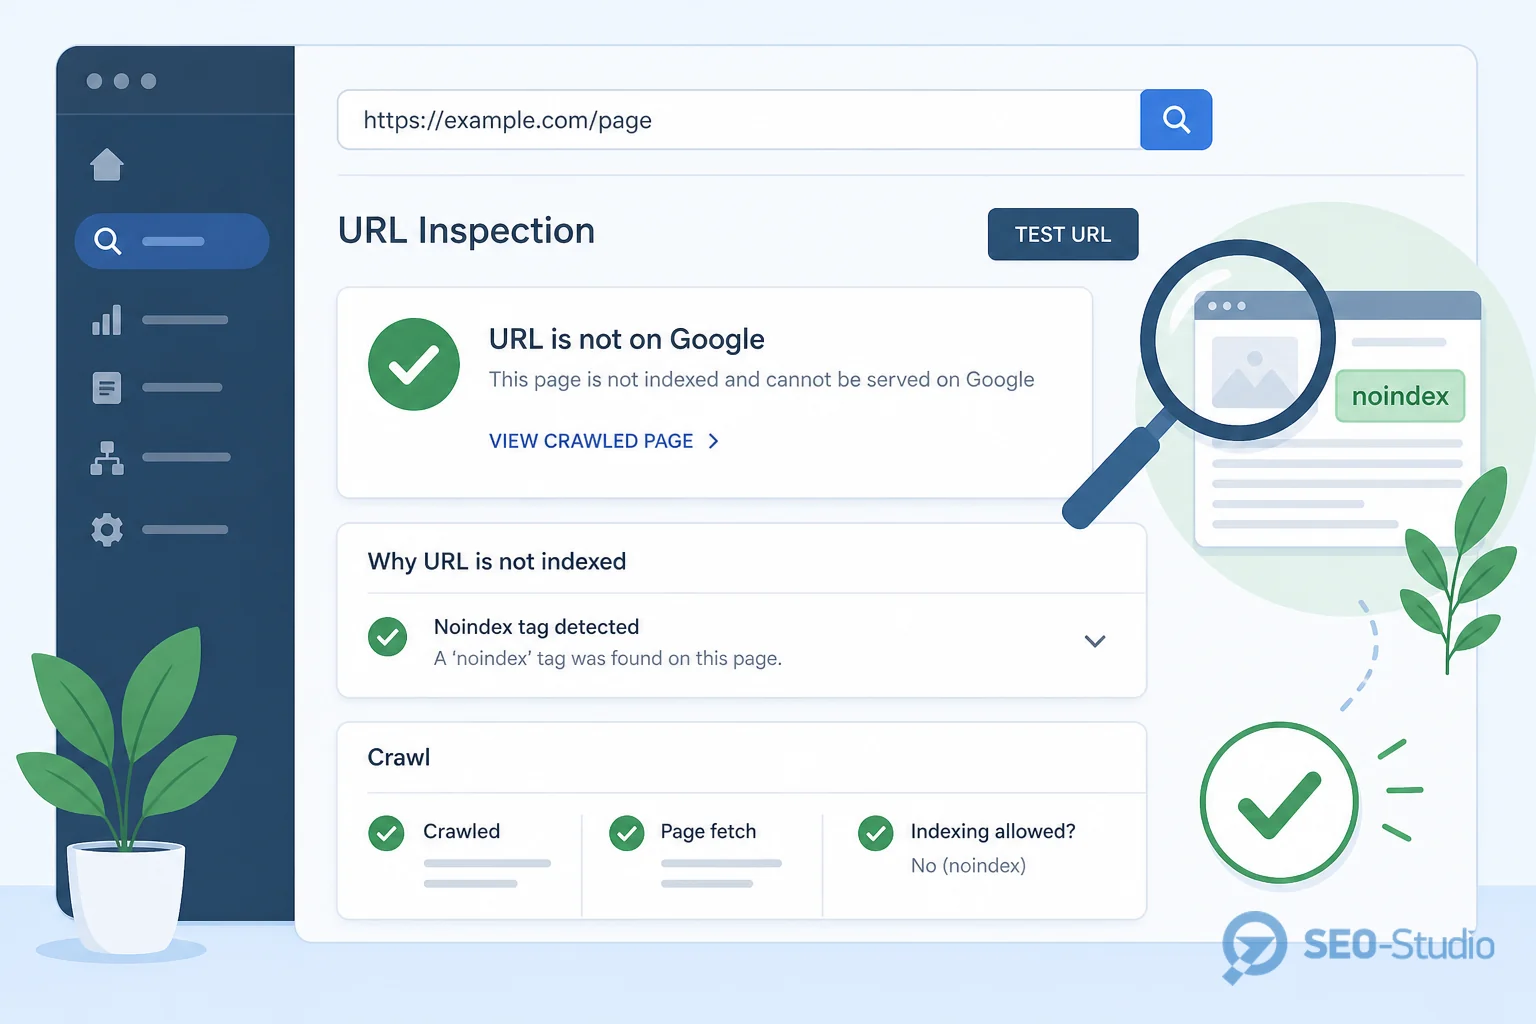
Короткий регламент после любого изменения noindex:
- Откройте URL без кэша, посмотрите код: есть ли meta robots / X-Robots-Tag именно с noindex.
- Убедитесь, что URL не Disallow в robots.txt — иначе проверка индексации будет неполной.
- В Google Search Console: проверка URL → запрос индексации для контрольных страниц; дальше смотрите «Страницы» / покрытие.
- Сохраните срез: какие URL должны остаться в индексе, какие — выпасть. Через 1–2 цикла обхода сверьте факт.
- Для бюджета обхода: в отчётах сканирования / статистике краулинга посмотрите, не доминируют ли служебные и параметрические URL; сравните долю «просканировано, но не проиндексировано» до и после чистки ссылок.
- Для денежных шаблонов держите отдельный чек-лист «никогда noindex» в релиз-процессе.
Если страница всё ещё в выдаче по site: или в отчёте «проиндексировано» — директива не доходит до бота, кэш ещё старый, или вы смотрите не тот хост/язык.
Заключение
Noindex — точный инструмент гигиены индекса, а не «кнопка SEO» и не замена управлению crawl budget. Он уместен для служебных, тонких и дублирующих URL и вреден, когда прячет страницы со спросом. Чтобы убрать URL из выдачи и не сливать обход на мусор, сочетайте noindex с архитектурой ссылок и статус-кодами. Правило простое: бот должен прочитать директиву, команда — иметь список исключений, а после релиза — проверку в HTML и Search Console.