Контекст и термины
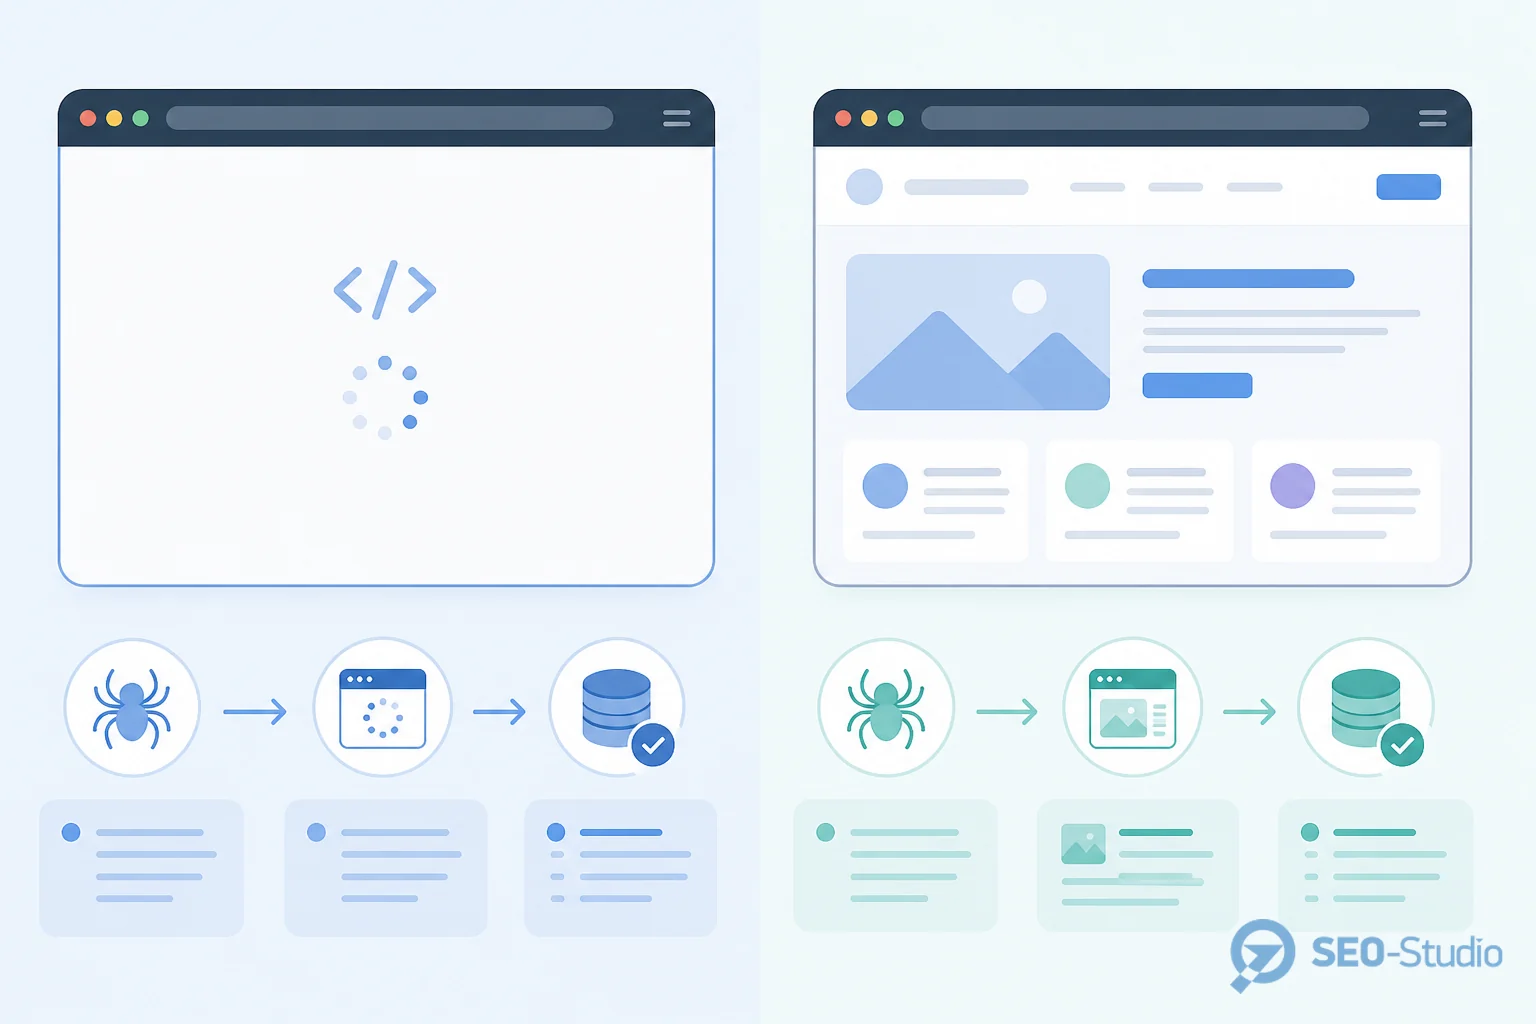
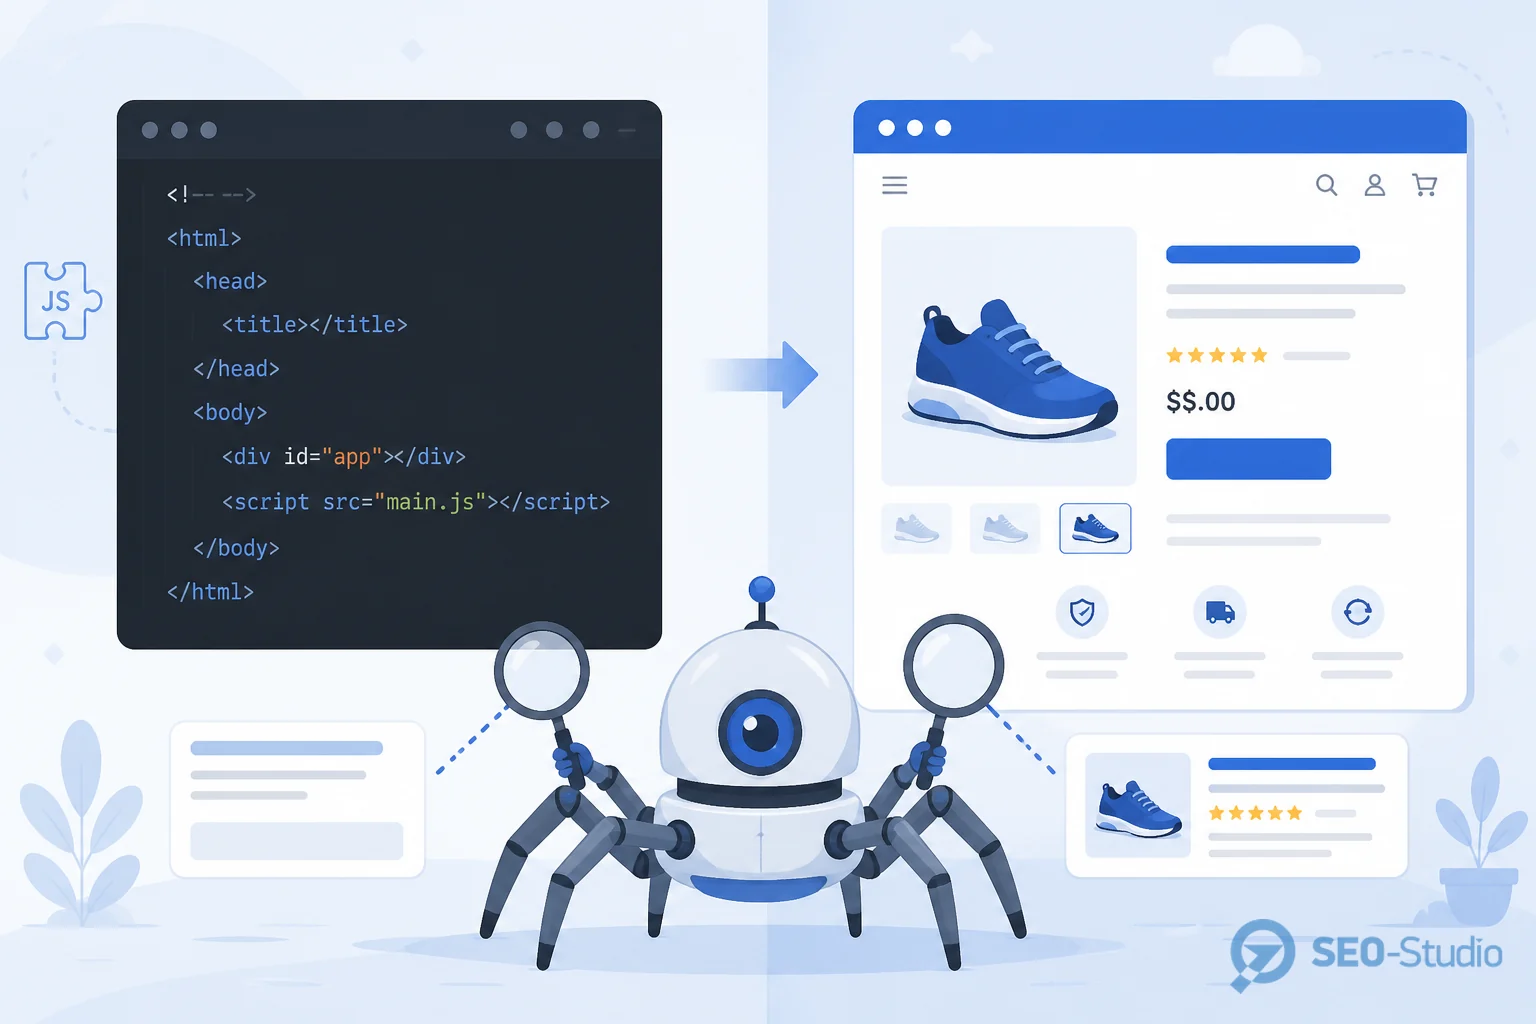
Google не «видит» React/Vue/Angular так, как пользователь в браузере. Сначала краулер получает HTML-ответ сервера, ставит URL в очередь на рендер (Web Rendering Service), выполняет JavaScript и только потом решает, что индексировать. Если важный текст, цены или ссылки появляются только после долгого клиентского рендера — индексация может задержаться или не состояться.
Полезные термины для диагностики:
- CSR (client-side rendering) — сервер отдаёт почти пустой каркас, контент собирает JS в браузере.
- SSR / SSG / hydration — HTML уже содержит основной контент; JS только «оживляет» интерфейс. Для SEO обычно более безопасный путь.
- Rendered HTML — HTML после выполнения JS в WRS. Именно его нужно сравнивать с тем, что видит пользователь.
- Soft 404 — сервер отвечает 200, но после рендера страница выглядит пустой или как «не найдено». Google часто не индексирует такие URL.
- Crawl budget на ресурсы — если robots.txt или CDN блокируют JS/CSS, рендер ломается даже при корректном роутинге.
Search Console здесь — главный источник правды: не «открывается ли сайт в Chrome», а «что именно Google смог отрендерить и проиндексировать».
Что делать на практике
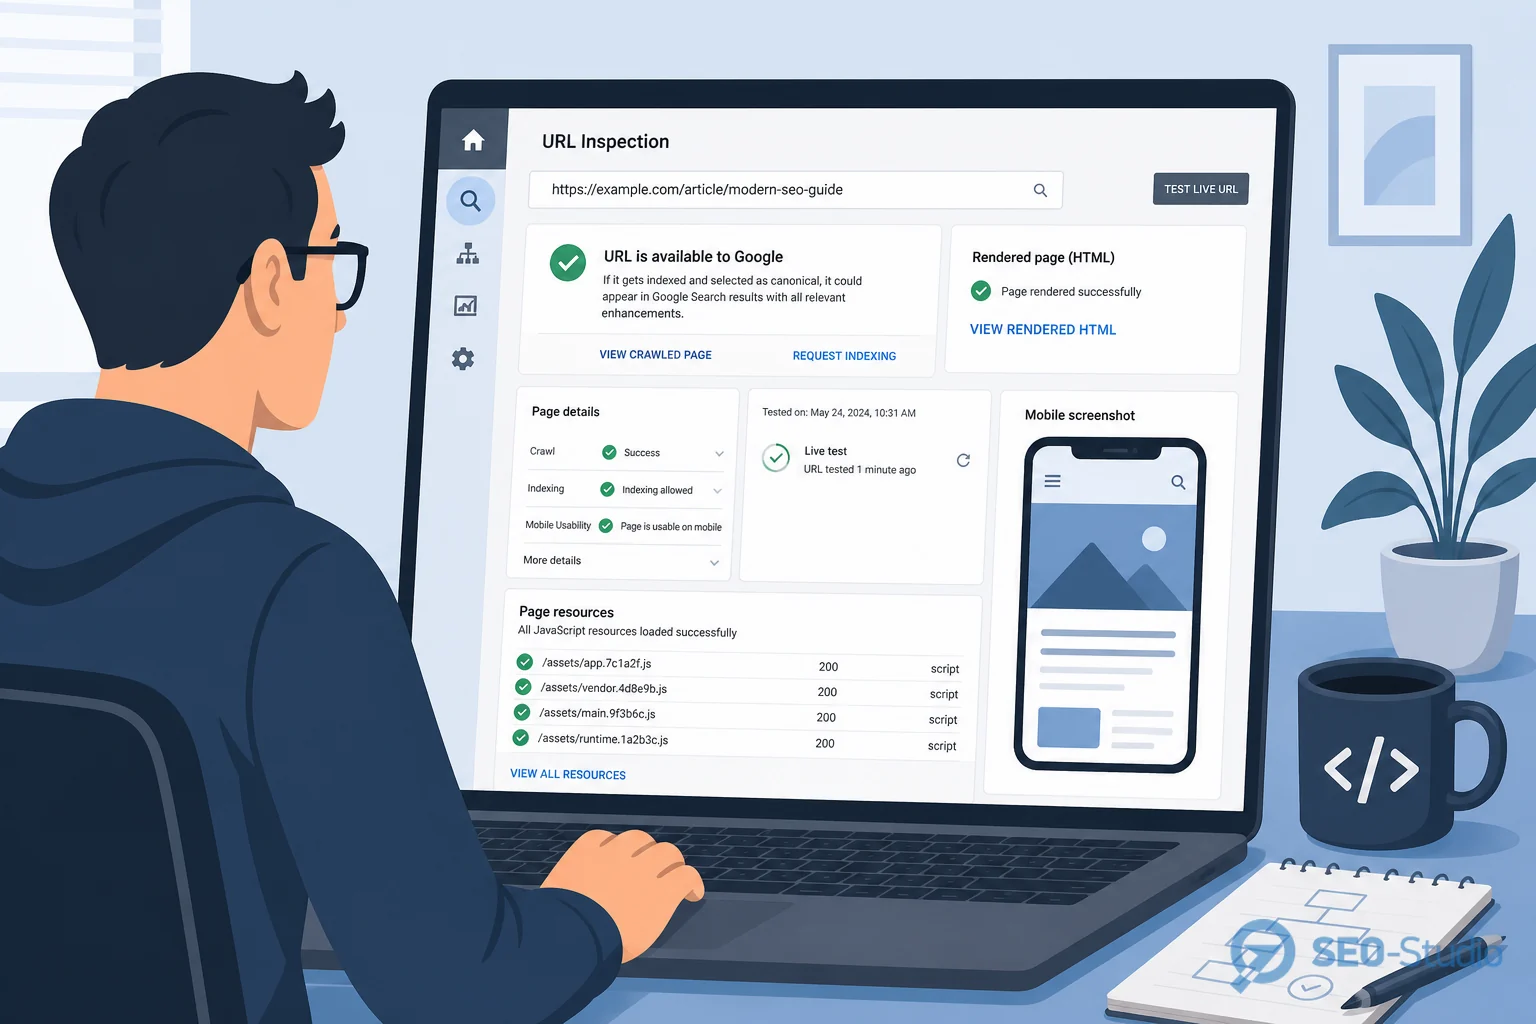
Прогоните эталонные URL (главная, категория, товар/услуга, пост блога, 404) через Проверку URL в Google Search Console.
- Откройте просмотренную страницу (или Live test) и сравните HTML с ожидаемым: есть ли H1, основной текст, цена, внутренние ссылки.
- Посмотрите скриншот: пустой экран, спиннер без контента или «заглушка» — сигнал, что рендер не успел или JS не отработал.
- В блоке загруженных ресурсов проверьте, нет ли заблокированных критичных
.js/.css. - Сверьте canonical, title и meta robots в отрендеренном HTML — SPA иногда подставляет их слишком поздно.
- Для пагинации и фильтров в SPA убедитесь, что каждое нужное состояние имеет отдельный crawlable URL (History API + серверный fallback), а не только hash-роутинг.
Параллельно в коде/инфраструктуре:
- Не блокируйте в
robots.txtпути со статикой фреймворка (/_next/,/static/, бандлы Vite/Webpack). - Отдавайте ключевой контент в первом HTML-ответе (SSR/SSG или prerender для ботов).
- Для API-данных, без которых нет текста страницы, сокращайте время до first meaningful content: критичные запросы — на сервере или с timeout-friendly путём.
- Настройте корректные HTTP-статусы для несуществующих SPA-маршрутов (настоящий 404, а не 200 с «Not found» в JS).
- Sitemap должен содержать финальные канонические URL, а не только
/с клиентским роутингом.
Типичные ошибки и риски
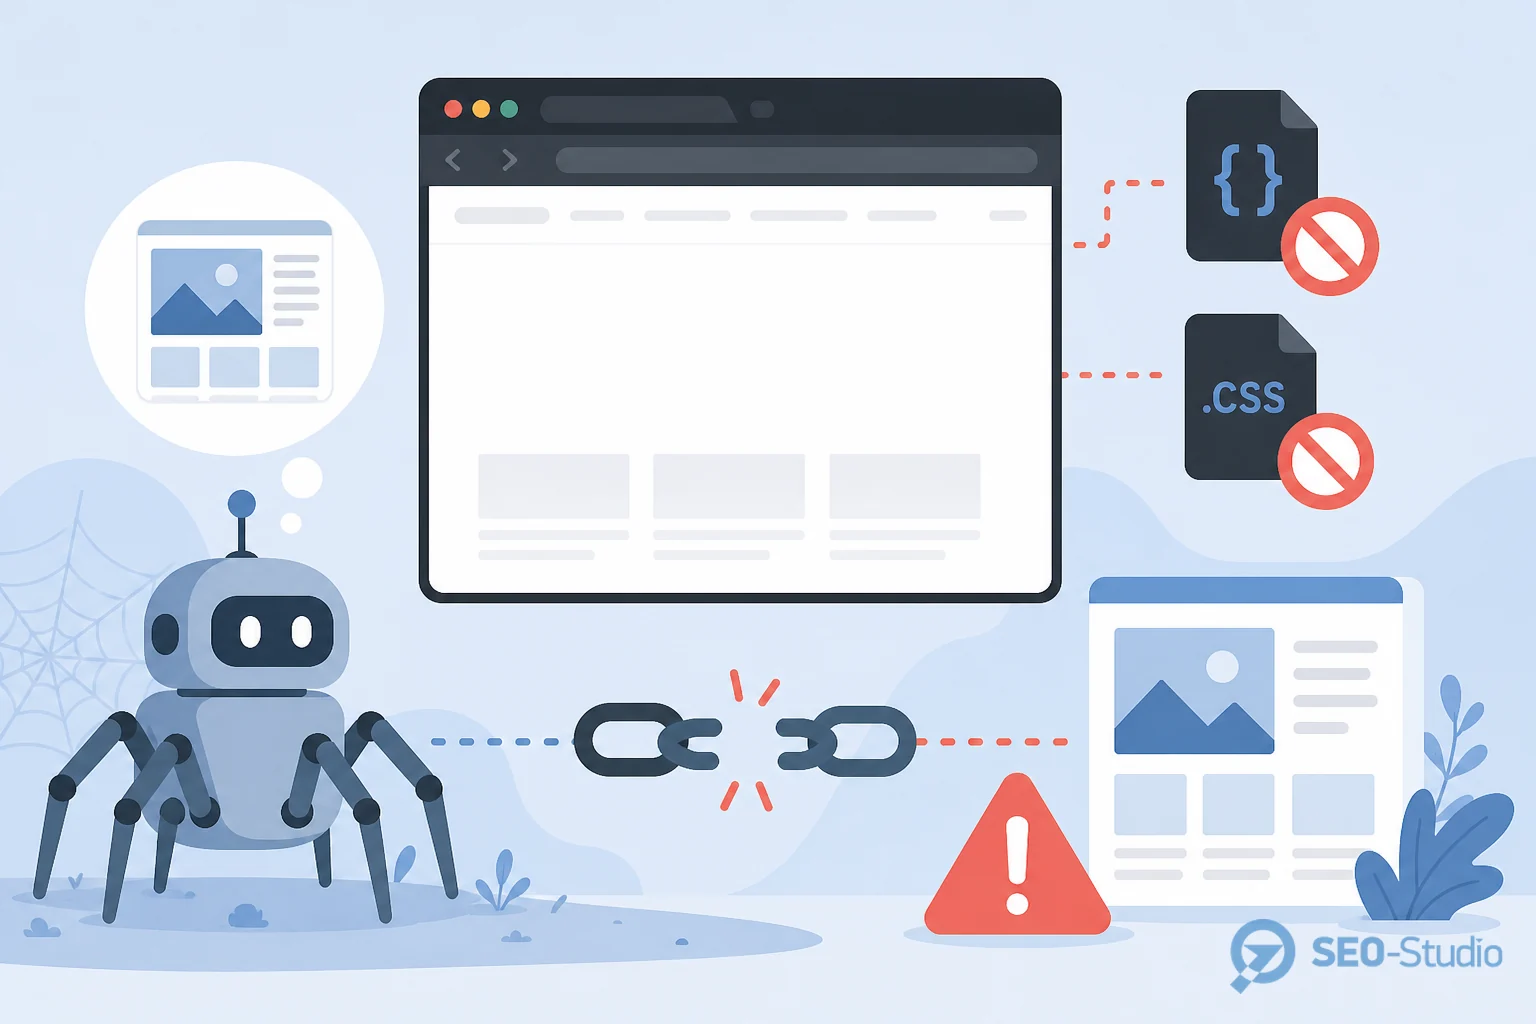
- robots.txt режет JS/CSS — классика: «в браузере всё ок», а в GSC — пустой рендер.
- Контент только после авторизации или клика — бот этого не сделает; проиндексирует пустышку.
- Infinite scroll без URL — глубокие позиции каталога не попадают в обход.
- Разный контент для User-Agent без согласованного prerender — риск cloaking и рассинхрона с Live test.
- Lazy hydration без SSR на денежных лендингах — title/H1 в индексе есть, а коммерческий блок «появляется позже» и индексируется нестабильно.
- Дубль главной через client routes (
/home,/#/, query-параметры сессий) размывает сигналы.
Не меняйте одновременно роутинг, robots.txt и шаблон метаданных: если индексация просядет, не поймёте, какое изменение виновато.
Как проверить результат
Контрольный чек-лист после правок:
- Повторная Проверка URL (live) на тех же эталонных страницах — HTML и скриншот содержат основной контент.
- Отчёт Page indexing: уменьшение «Crawled — currently not indexed» / soft 404 для исправленных шаблонов.
- Сравнение site: и выборки из sitemap: новые/обновлённые JS-страницы появляются в индексе за несколько циклов обхода.
- В Coverage / Page indexing нет массовых причин вроде «Blocked by robots.txt» для статических бандлов.
- Внутренняя перелинковка с SSR-страниц ведёт на канонические URL SPA, а не на hash-ссылки.
Зафиксируйте дату проверки и список URL в тикете — через 2–3 недели проще подтвердить, что регрессии после следующего релиза фронта нет.
Заключение
Индексация JavaScript-сайта — это проверка не «работает ли UI», а видит ли Google тот же контент после рендера. Держите критичный HTML на сервере или в быстром prerender, не блокируйте ресурсы рендера, отдавайте честные статус-коды и регулярно прогоняйте эталонные URL через Search Console. Если нужен аудит CSR/SSR, приоритеты для разработки и контроль индексации после релизов — обратитесь к команде SEO-Studio.