Синтаксис robots.txt без сюрпризов
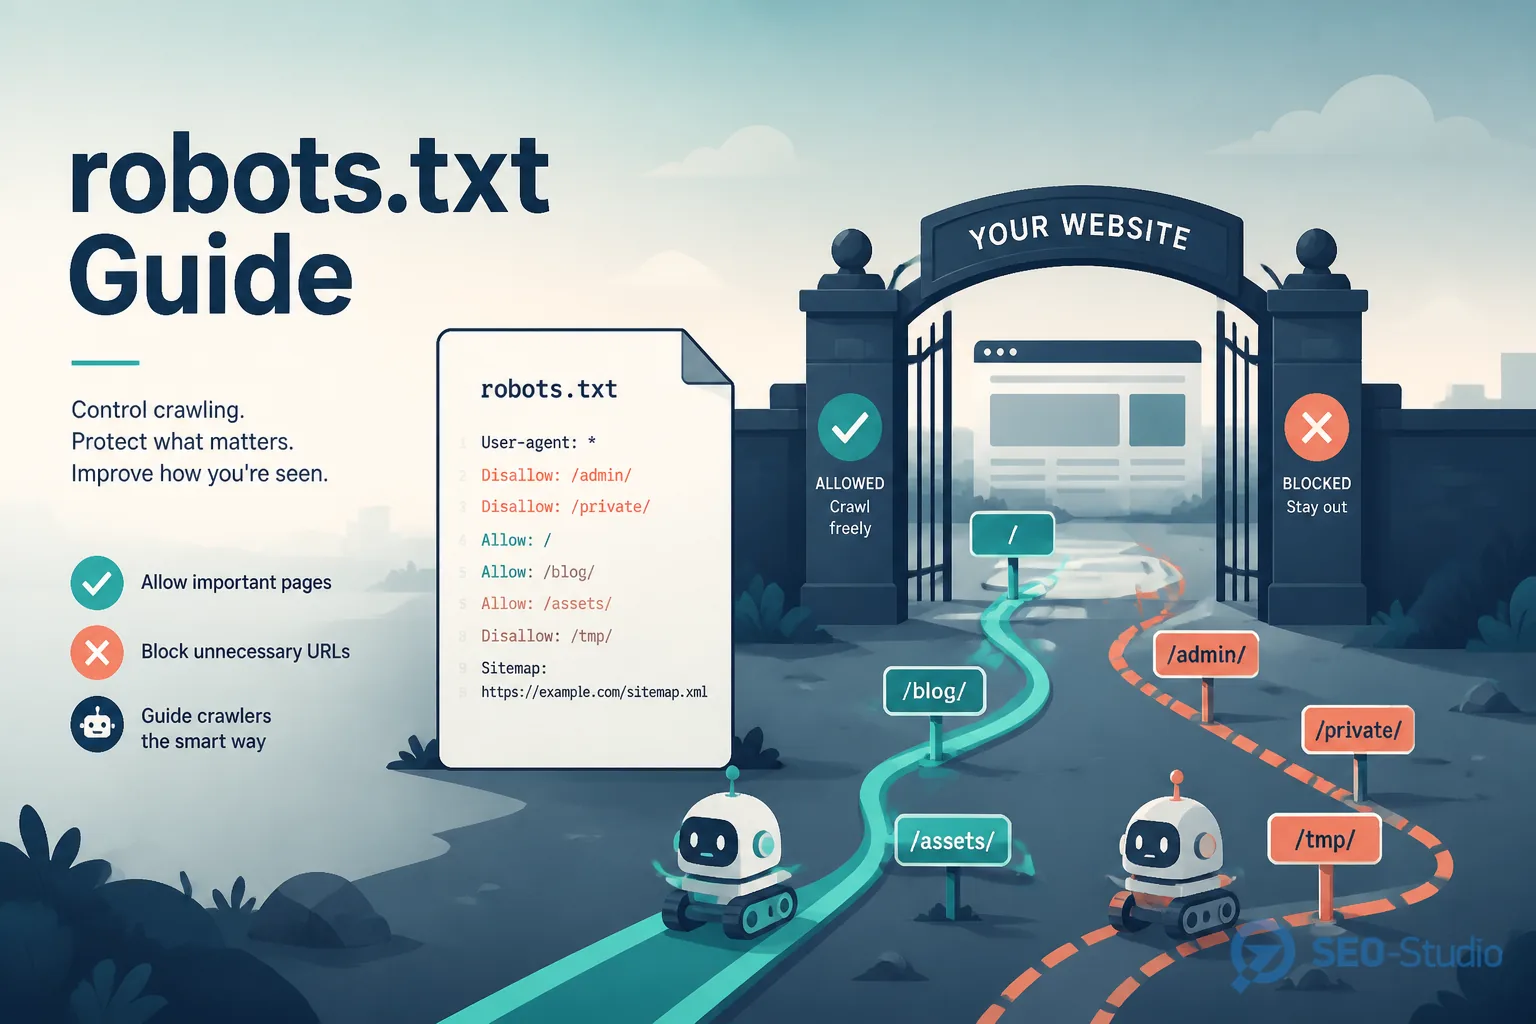
robots.txt — текстовый файл в корне домена, который подсказывает краулерам, что можно сканировать. Официальные правила в документации Google о robots.txt.
Минимальный рабочий шаблон для WordPress:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
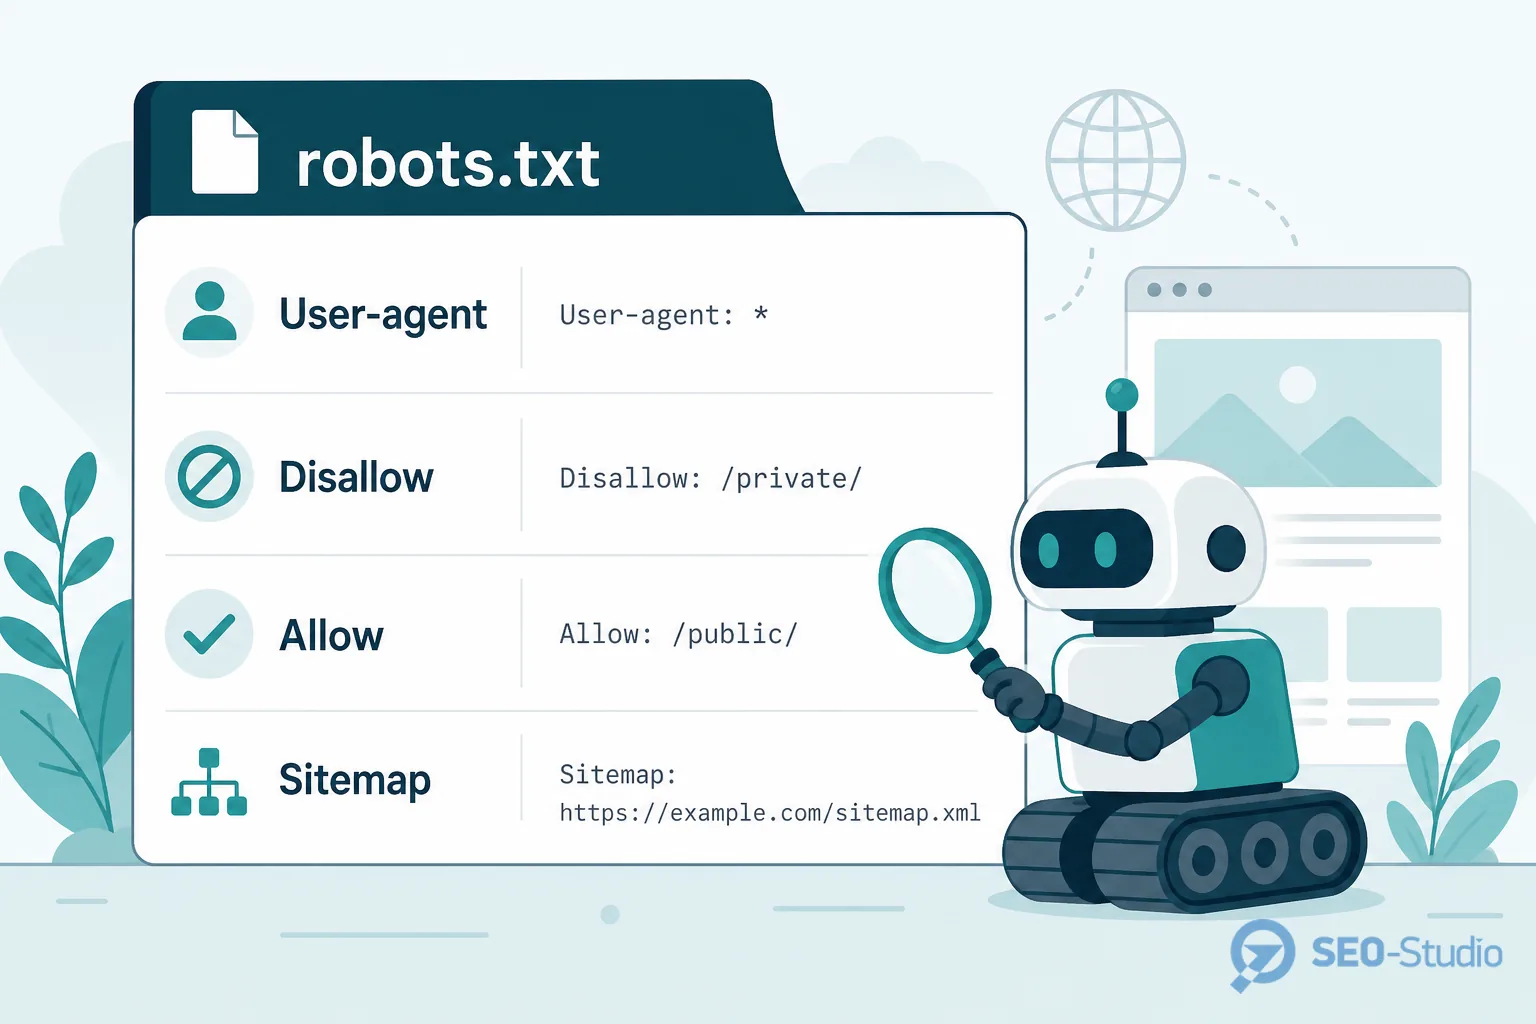
Sitemap: https://example.com/sitemap_index.xml- Каждый
User-agentначинает новый блок правил. Disallowзапрещает префикс пути. Пустой Disallow ничего не блокирует.Allowсужает Disallow — полезно для admin-ajax и отдельных подпутей.- Регистр и слеши важны.
/pageи/page/— разные правила.
Файл должен отдаваться с HTTP 200 и типом text/plain. Редирект с www на non-www не должен ломать путь к robots.txt.
Disallow против noindex и crawl budget
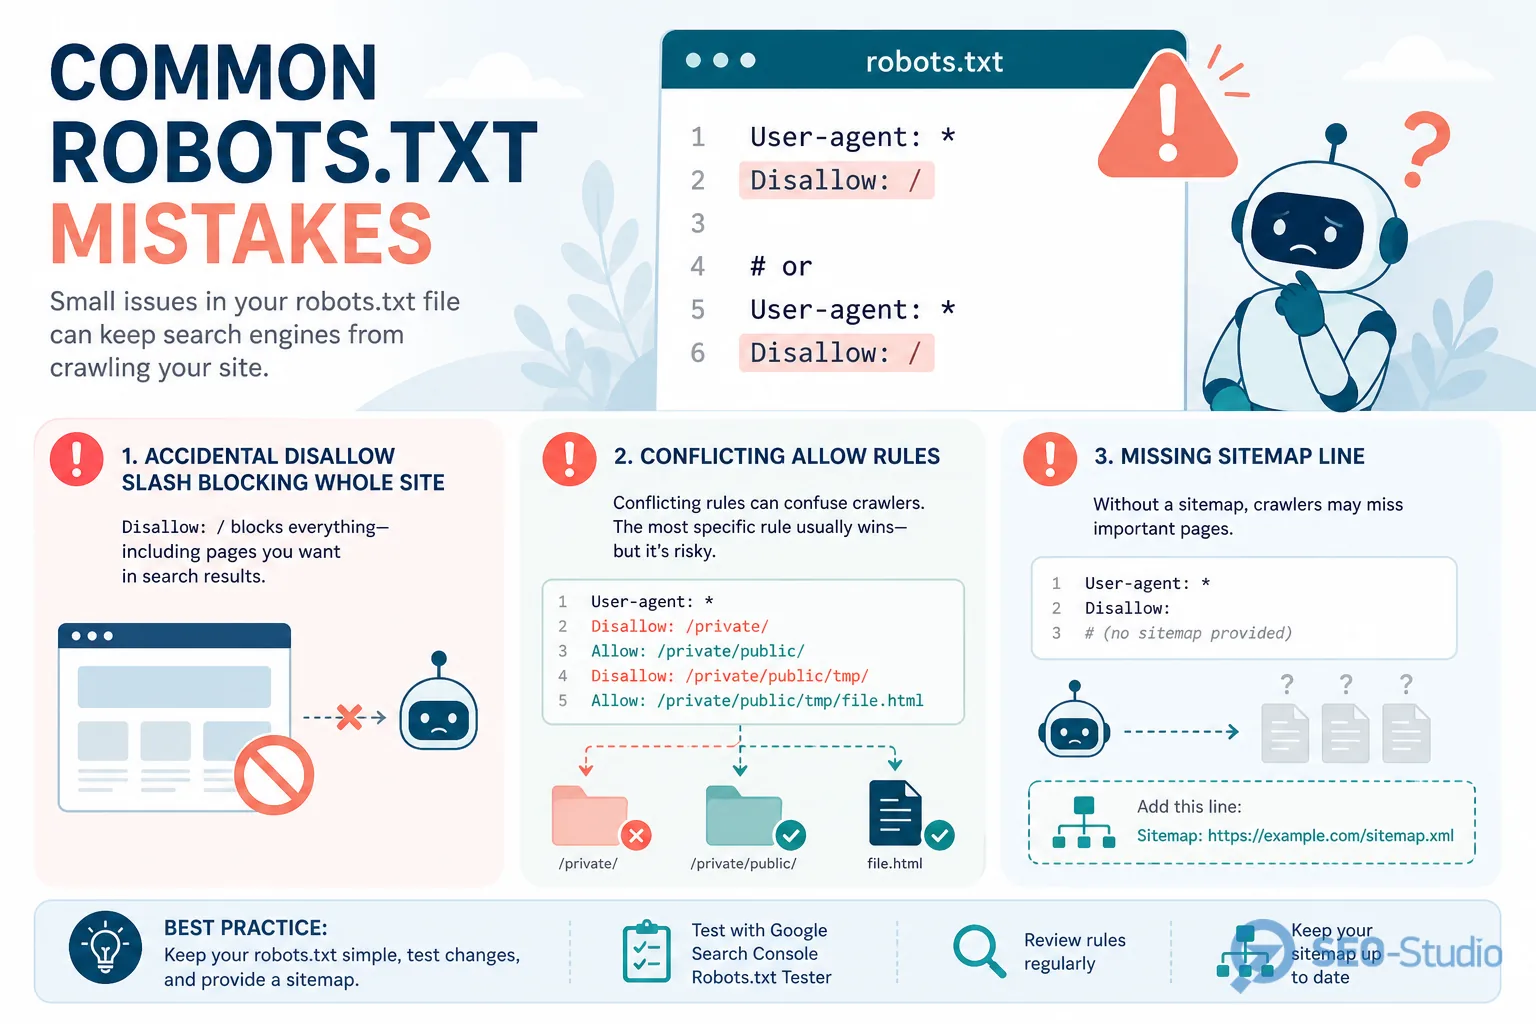
Самая частая путаница. Disallow говорит «не заходи сканировать», но не гарантирует удаление из индекса. noindex в HTML/meta говорит «не показывай в выдаче», но бот должен увидеть страницу. Подробнее о разнице noindex и robots.txt.
- Закрыли noindex-страницу в Disallow — Google может не прочитать директиву и держать URL в выдаче.
- Надеетесь, что Disallow «сэкономит» crawl budget — бот часто всё равно тратит обход на проверку, а страница остаётся в индексе.
- Блокируете CSS/JS (
/wp-content/,/_next/static/) — ломается рендер и индексация SPA. - Дублируете противоречивые правила для разных user-agent без теста.
- Забыли убрать Disallow со staging после переноса на прод.
Правильная схема для служебных URL. Сначала разрешить сканирование, поставить noindex в шаблоне, затем при необходимости ограничить только то, что точно не должно попасть в индекс и не требует проверки.
Проверка в Search Console
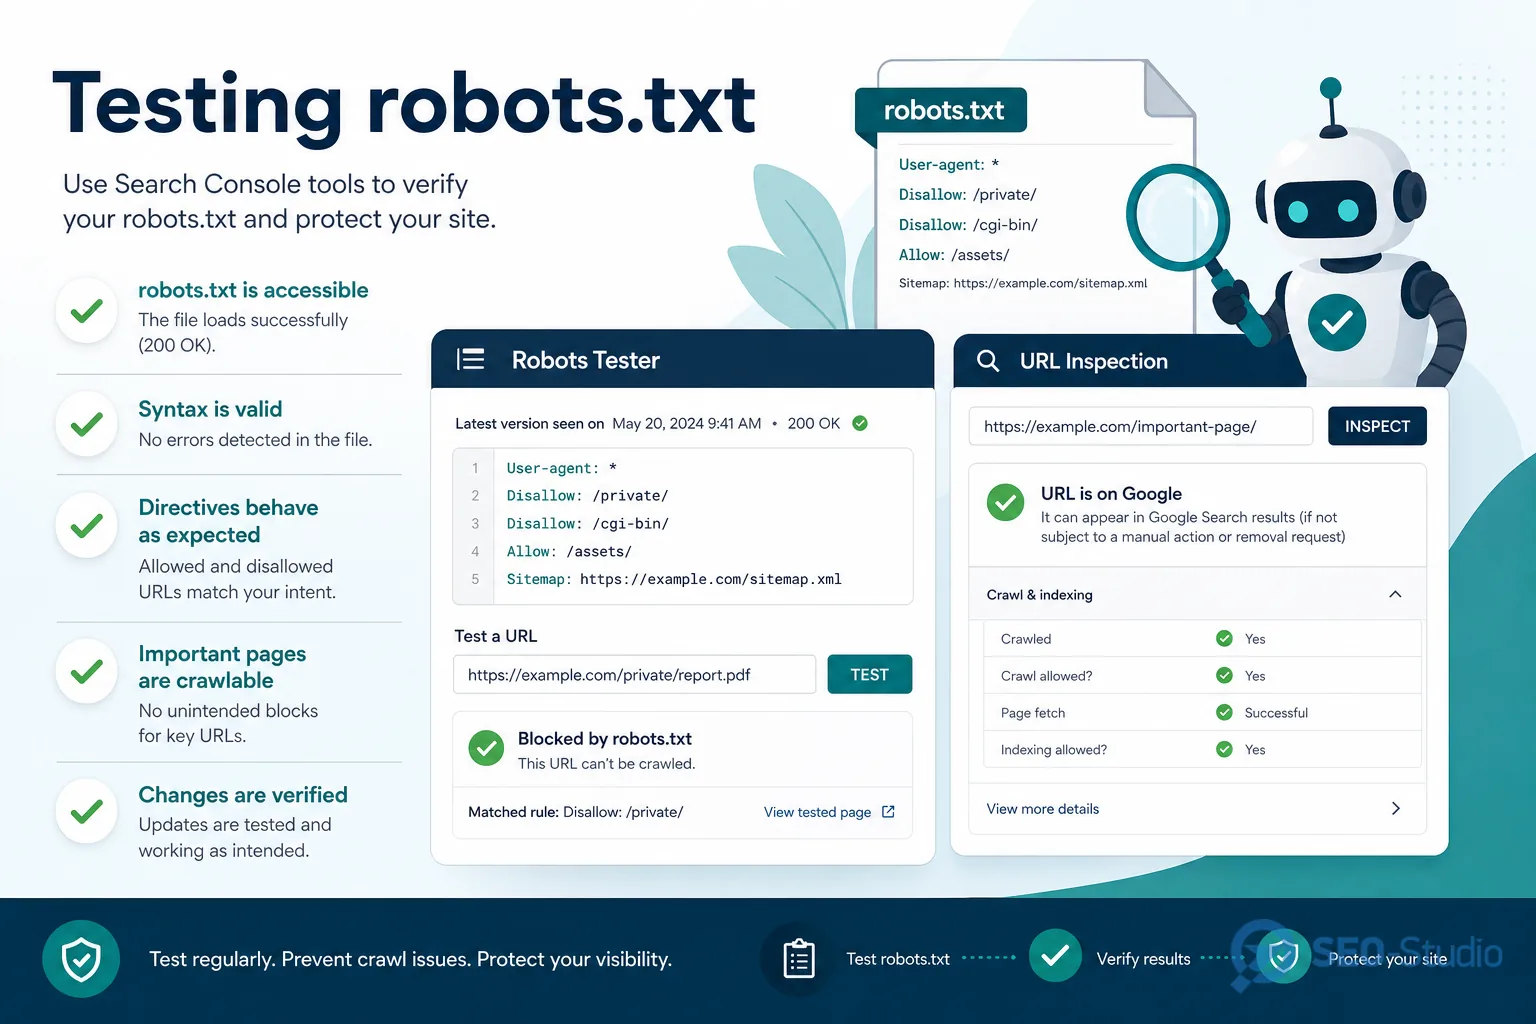
После каждого изменения robots.txt проверяйте не «в целом ок», а конкретные URL.
- Откройте тестер robots.txt в Search Console. Подайте пути главной, категорий, sitemap, wp-admin.
- В URL Inspection проверьте «Page fetch» и «Indexing allowed?» для эталонных страниц.
- В отчёте Page indexing ищите «Blocked by robots.txt» для важных шаблонов.
- Сверьте live-версию файла (
curl -I https://site/robots.txt) с тем, что редактировали в CMS/CDN. - Если есть кеш CDN — сбросьте его после правки, иначе Google видит старую версию.
Строка Sitemap и приоритеты обхода
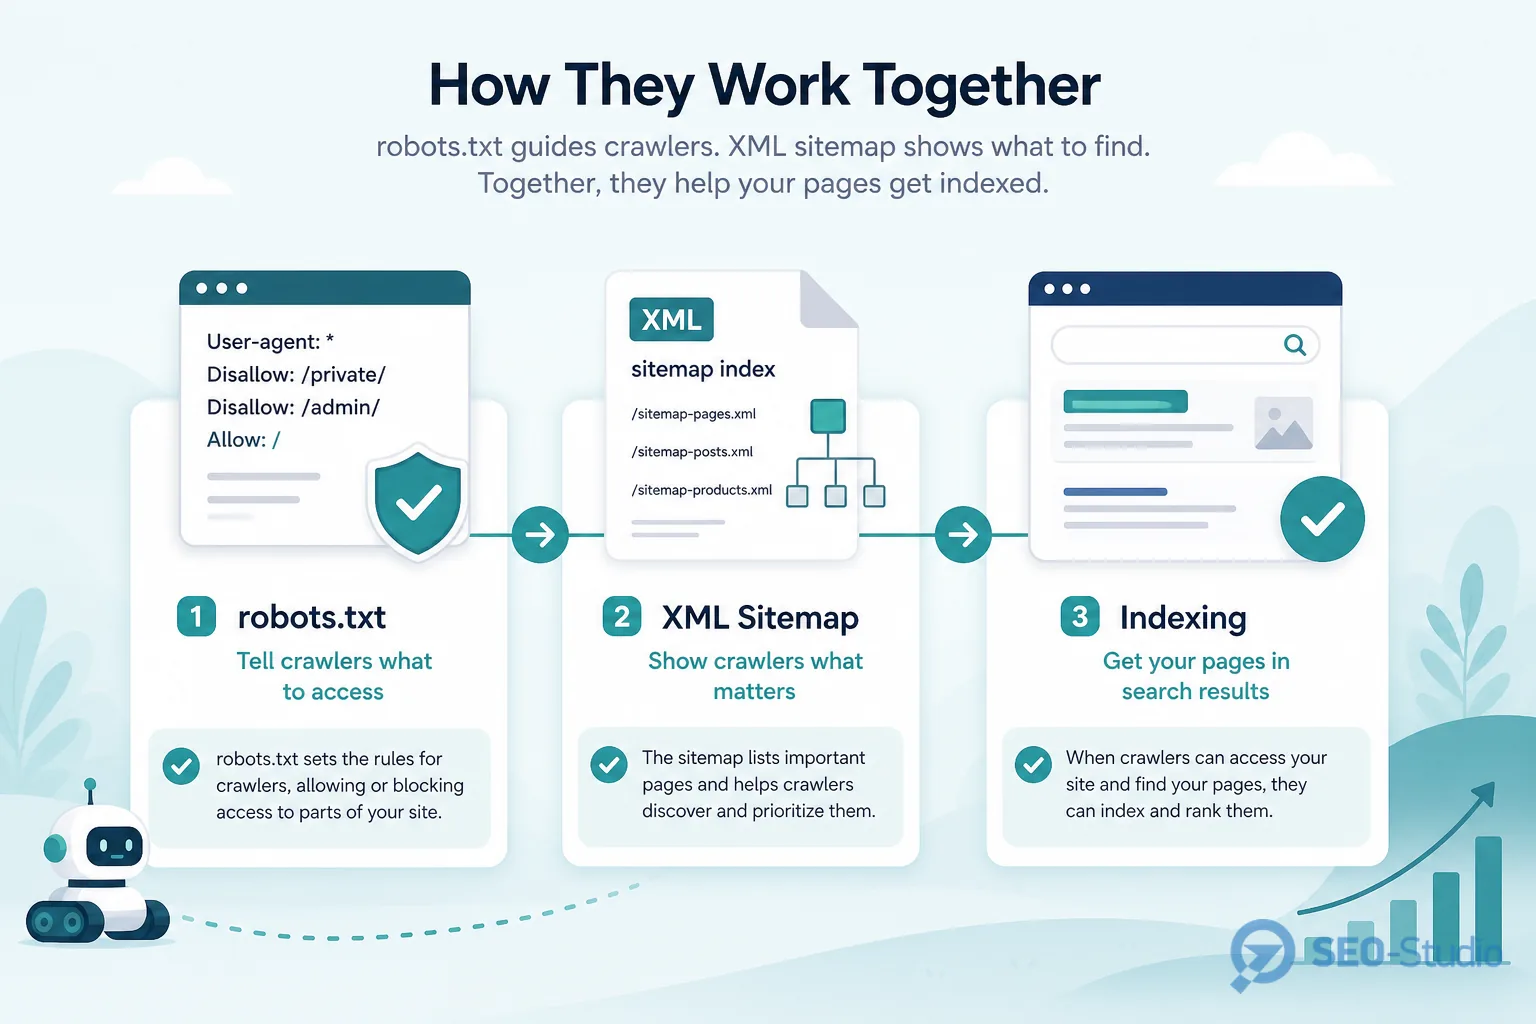
Директива Sitemap: указывает на XML-карту сайта. Она не заменяет внутренние ссылки, но ускоряет нахождение карты после миграций.
- Указывайте абсолютный URL с https и правильным доменом (www или без).
- Для мультиязычных сайтов — индексную sitemap или отдельные строки на каждый язык.
- Не добавляйте в sitemap URL, закрытые Disallow — сигналы противоречат друг другу.
- После больших релизов проверьте, что новая sitemap доступна и не возвращает 404.
Заключение
robots.txt управляет сканированием, а не индексацией напрямую. Не путайте Disallow с noindex, не режьте статику, тестируйте критичные URL в Search Console и держите Sitemap актуальной. Если нужен аудит robots.txt вместе со структурой сайта, команда SEO-Studio поможет найти конфликты до того, как они ударят по индексации.