Контекст и термины
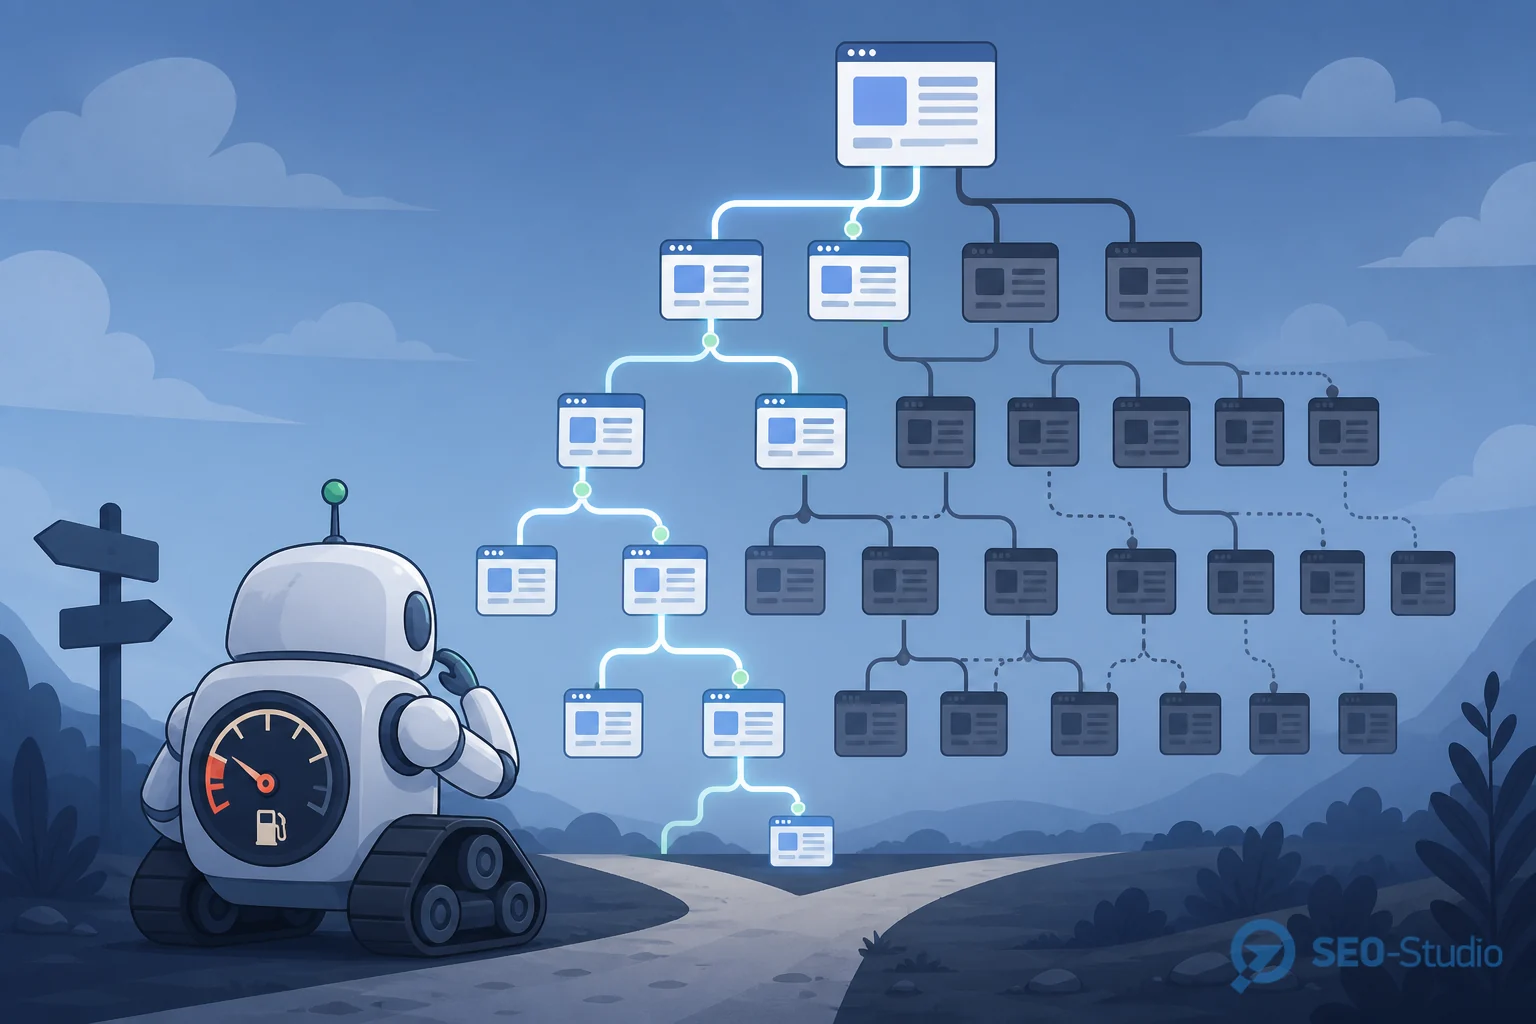
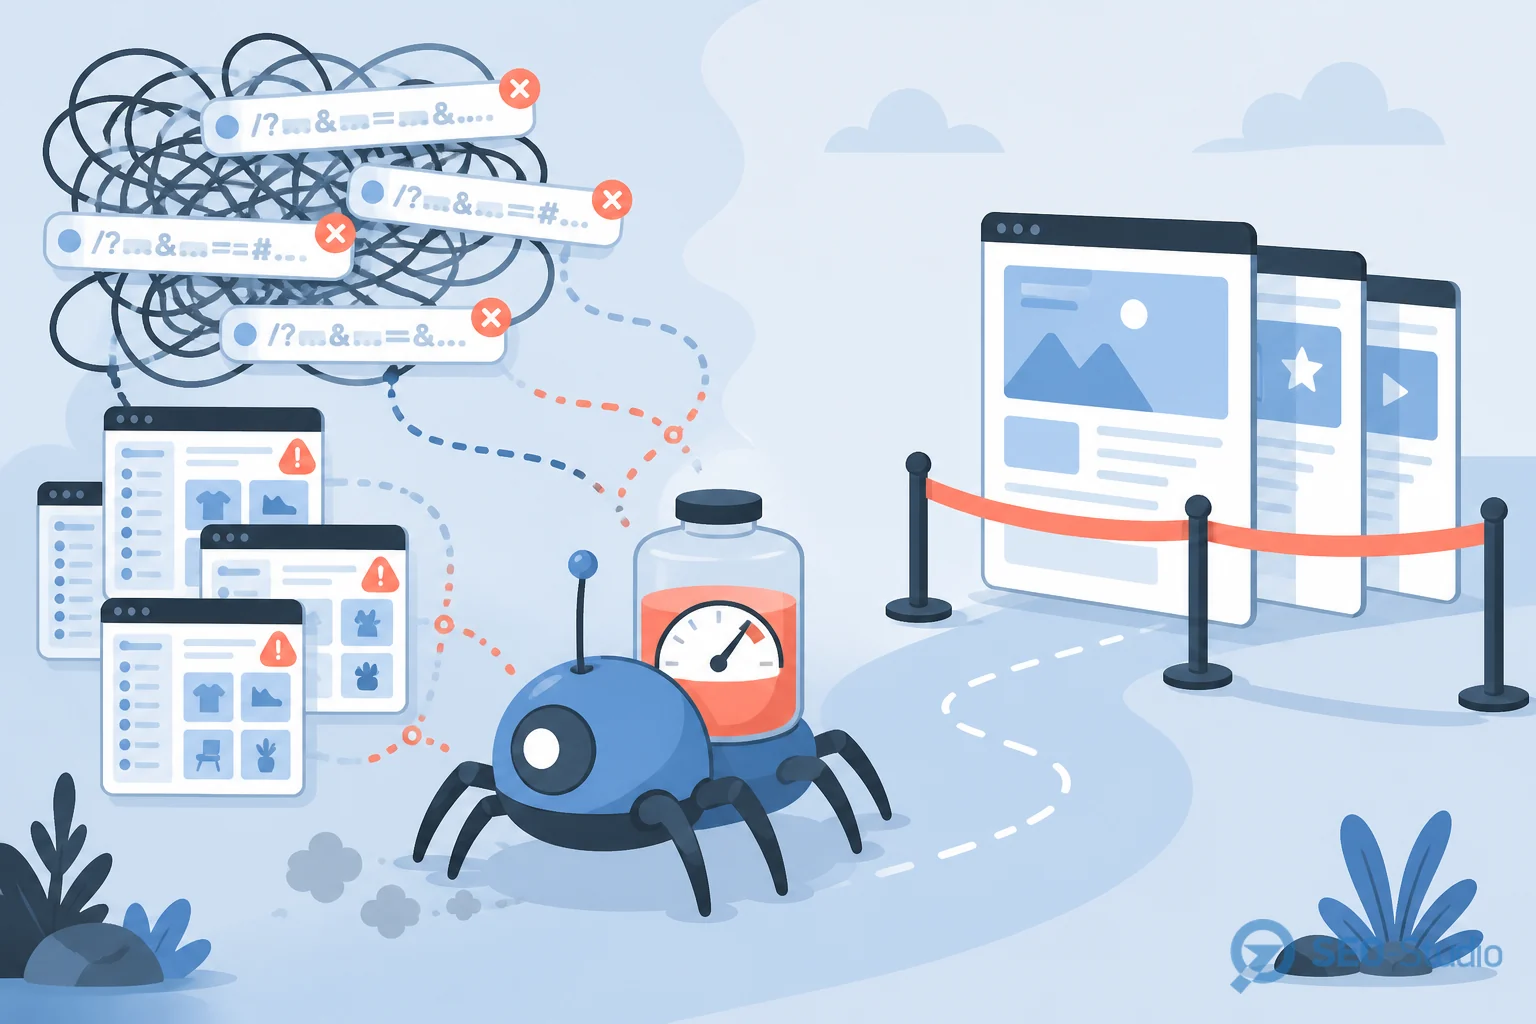
Crawl budget — практический предел, сколько URL Googlebot готов и способен регулярно сканировать на вашем хосте. Google описывает управление обходом для крупных сайтов в Managing crawl budget for large sites. Для маленького сайта с чистой структурой «бюджет» почти не ощутим; для каталогов, фасетов и JS-витрин он становится узким местом индексации.
Полезные различия:
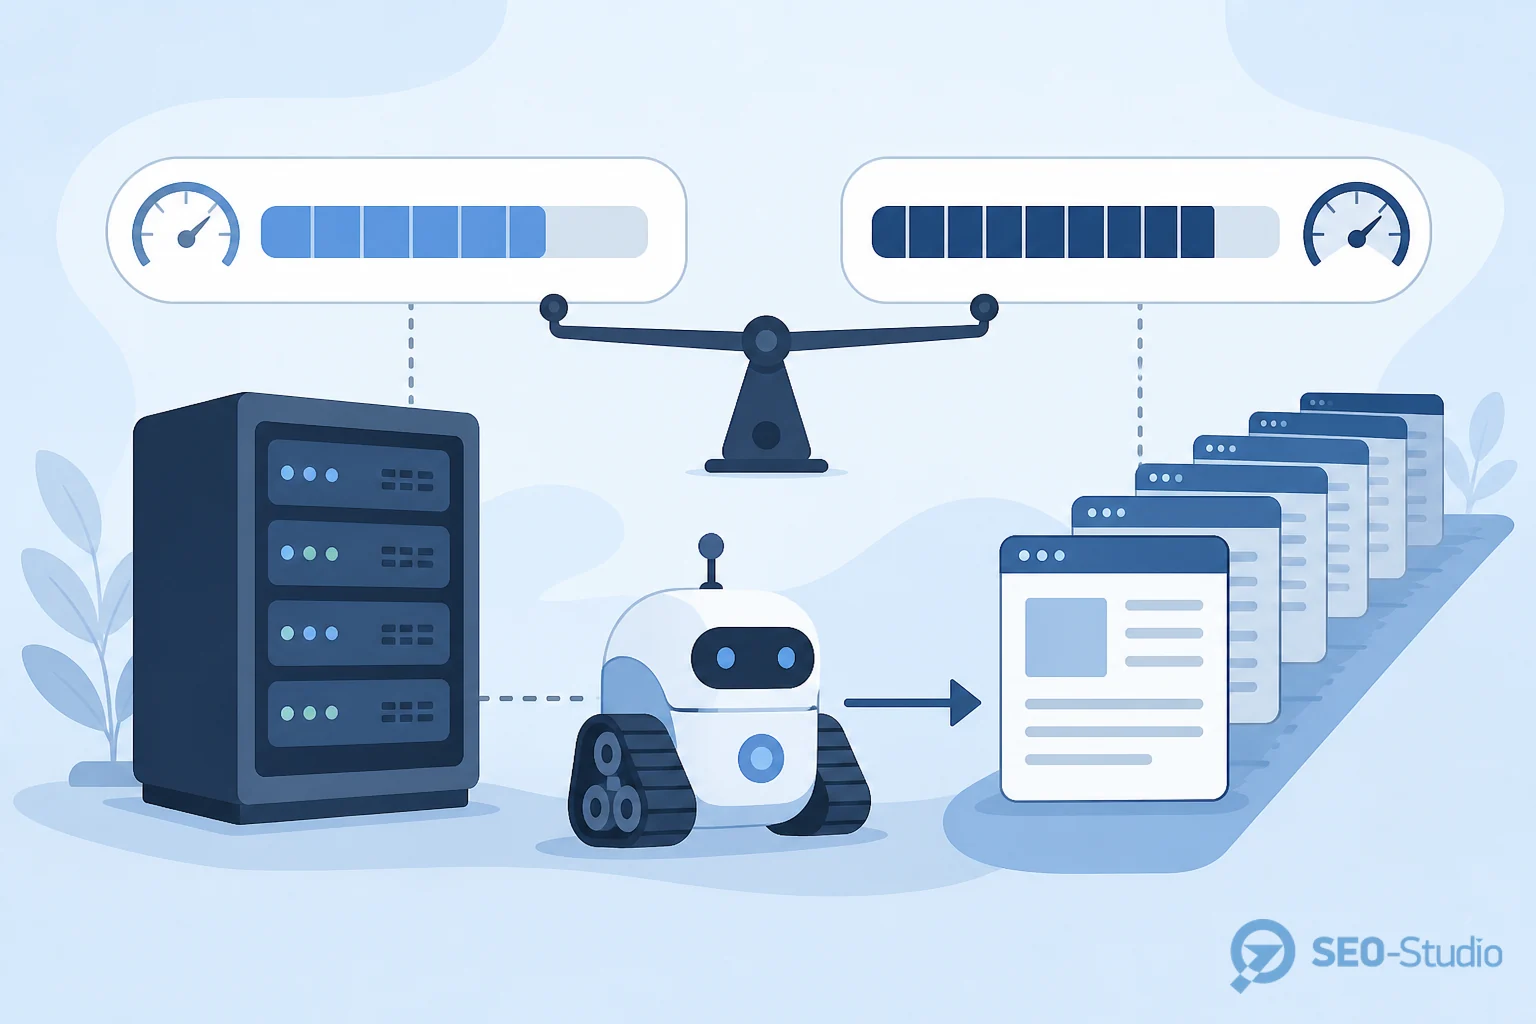
- Crawl rate / capacity — сколько запросов сервер нормально выдерживает без ошибок и таймаутов.
- Crawl demand — насколько Google считает URL важными (ссылки, обновления, трафик, сигналы качества).
- Индексация ≠ обход — страницу могут просканировать и не проиндексировать; или наоборот долго не заходить на новый URL.
- Noindex ≠ экономия бюджета — бот часто всё равно заходит, чтобы прочитать директиву. Подробнее когда noindex уместен.
Если сайт на JavaScript, часть «бюджета» ещё уходит на ресурсы рендера. Тогда параллельно смотрите индексацию JavaScript-сайтов в Search Console.
Что делать на практике
Цель не «увеличить магическое число», а чтобы Google чаще и стабильнее видел денежные URL.
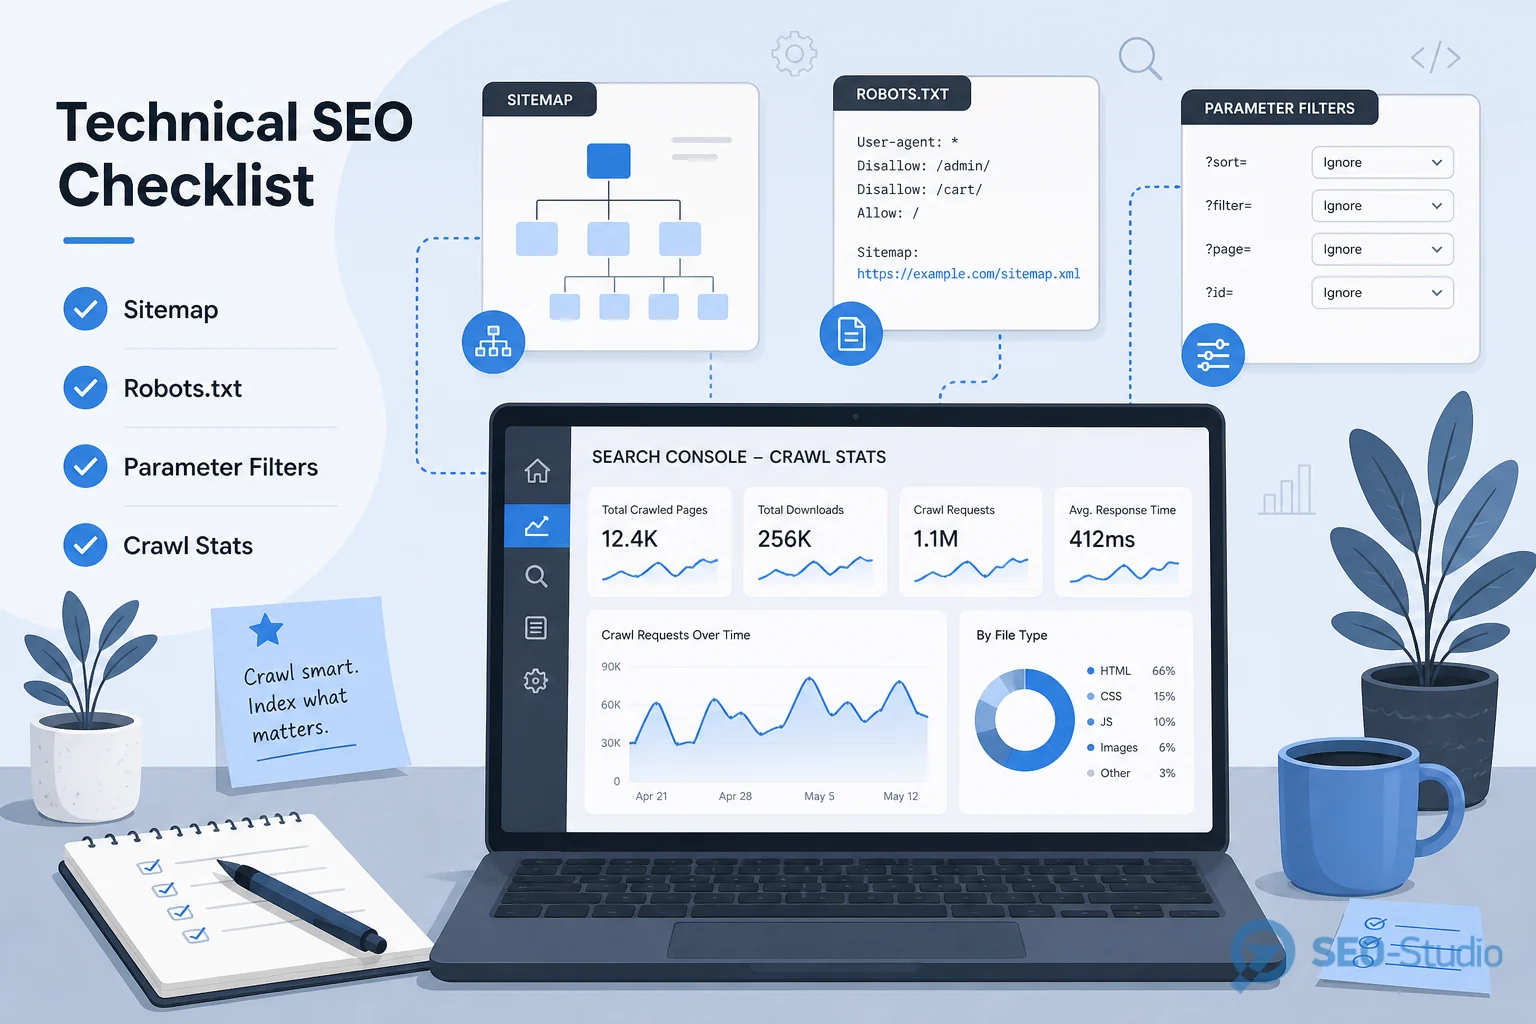
- Соберите эталонные URL (главная, топ-категории, топ-товары/услуги, важные статьи) и прогоните через URL Inspection.
- Уберите из внутренней перелинковки мусорные комбинации фильтров/сортировок или сделайте их некраулабельными без пользы.
- Держите XML-карту только с каноническими URL, которые должны быть в индексе; обновляйте её после крупных релизов.
- Проверьте, что robots.txt не блокирует CSS/JS и важные разделы, но и не открывает служебные без нужды.
- Для мёртвых страниц отдавайте 404/410 вместо вечного 200; для тонких служебных — noindex + меньше ссылок, а не «всё в Disallow».
- Сократите цепочки редиректов и дубли (www/non-www, trailing slash, HTTP→HTTPS) — каждый лишний прыжок ест обход.
На крупном e-commerce заведите отдельный backlog «фасеты/параметры» с приоритетом, иначе crawl budget съедят комбинации, которых нет в спросе.
Типичные ошибки и риски
- Считать, что noindex сам по себе «освобождает» crawl budget.
- Закрыть в robots.txt то, что нужно проиндексировать, или наоборот оставить открытыми тысячи параметрических дублей.
- Sitemap со всем подряд, включая noindex и редиректы.
- Бесконечная пагинация / calendar archives / теги без пользы.
- Медленный TTFB и волны 5xx — Google снижает интенсивность обхода.
- SPA без нормальных URL и статус-кодов (см. материал про JS-индексацию).
Риск простой. Пока бот жуёт мусор, свежие или коммерческие страницы обновляются реже — и вы видите «просадку» там, где контент вроде бы «в порядке».
Как проверить результат
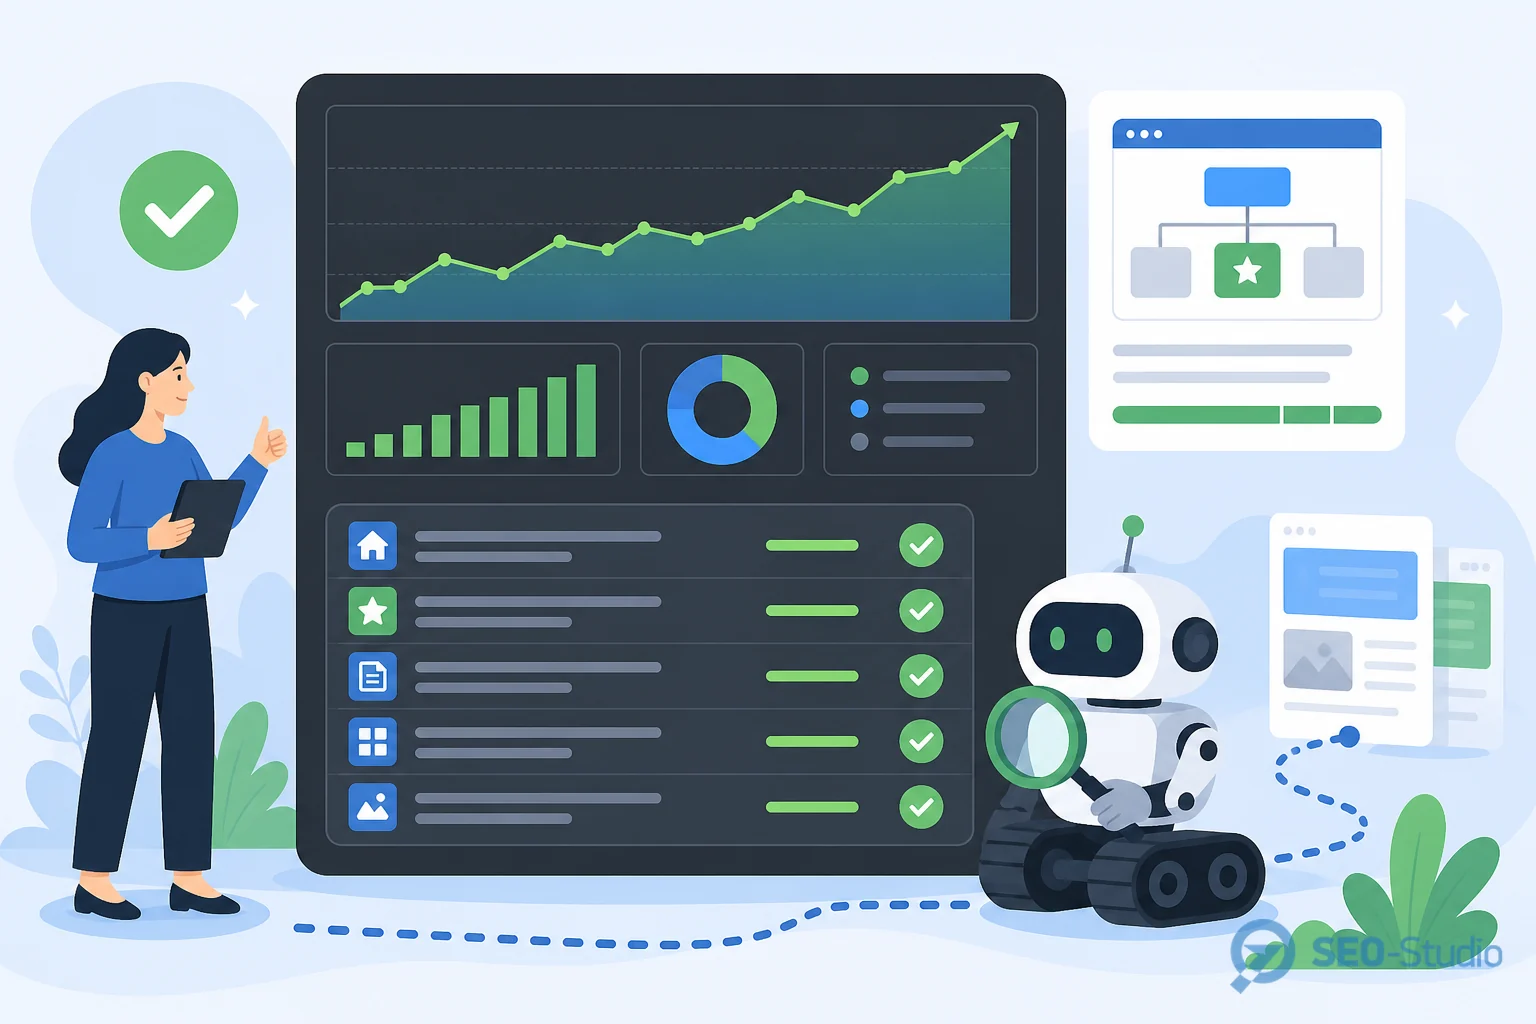
- В Search Console сравните статистику сканирования до/после. Меньше ошибок хоста, стабильнее обход важных путей.
- В Page indexing уменьшается доля «просканировано, но не проиндексировано» для мусорных шаблонов и растёт покрытие целевых.
- Эталонные URL в URL Inspection показывают более свежую дату обхода.
- Логи сервера / CDN. Доля хитов Googlebot на денежные пути vs параметры.
- Через 2–4 недели сверьте, попадают ли новые посадочные из sitemap в индекс без ручного «просить проиндексировать» на каждую.
Заключение
Crawl budget важен не как абстрактная метрика, а как способ не тратить обход Google на мусор. Чистите параметры и дубли, держите здоровую sitemap, не путайте noindex с экономией сканирования и проверяйте эффект в Search Console. Если нужен аудит крупных каталогов и приоритизация backlog — команда SEO-Studio поможет с диагностикой и внедрением.