
Синтаксис robots.txt без сюрпризів
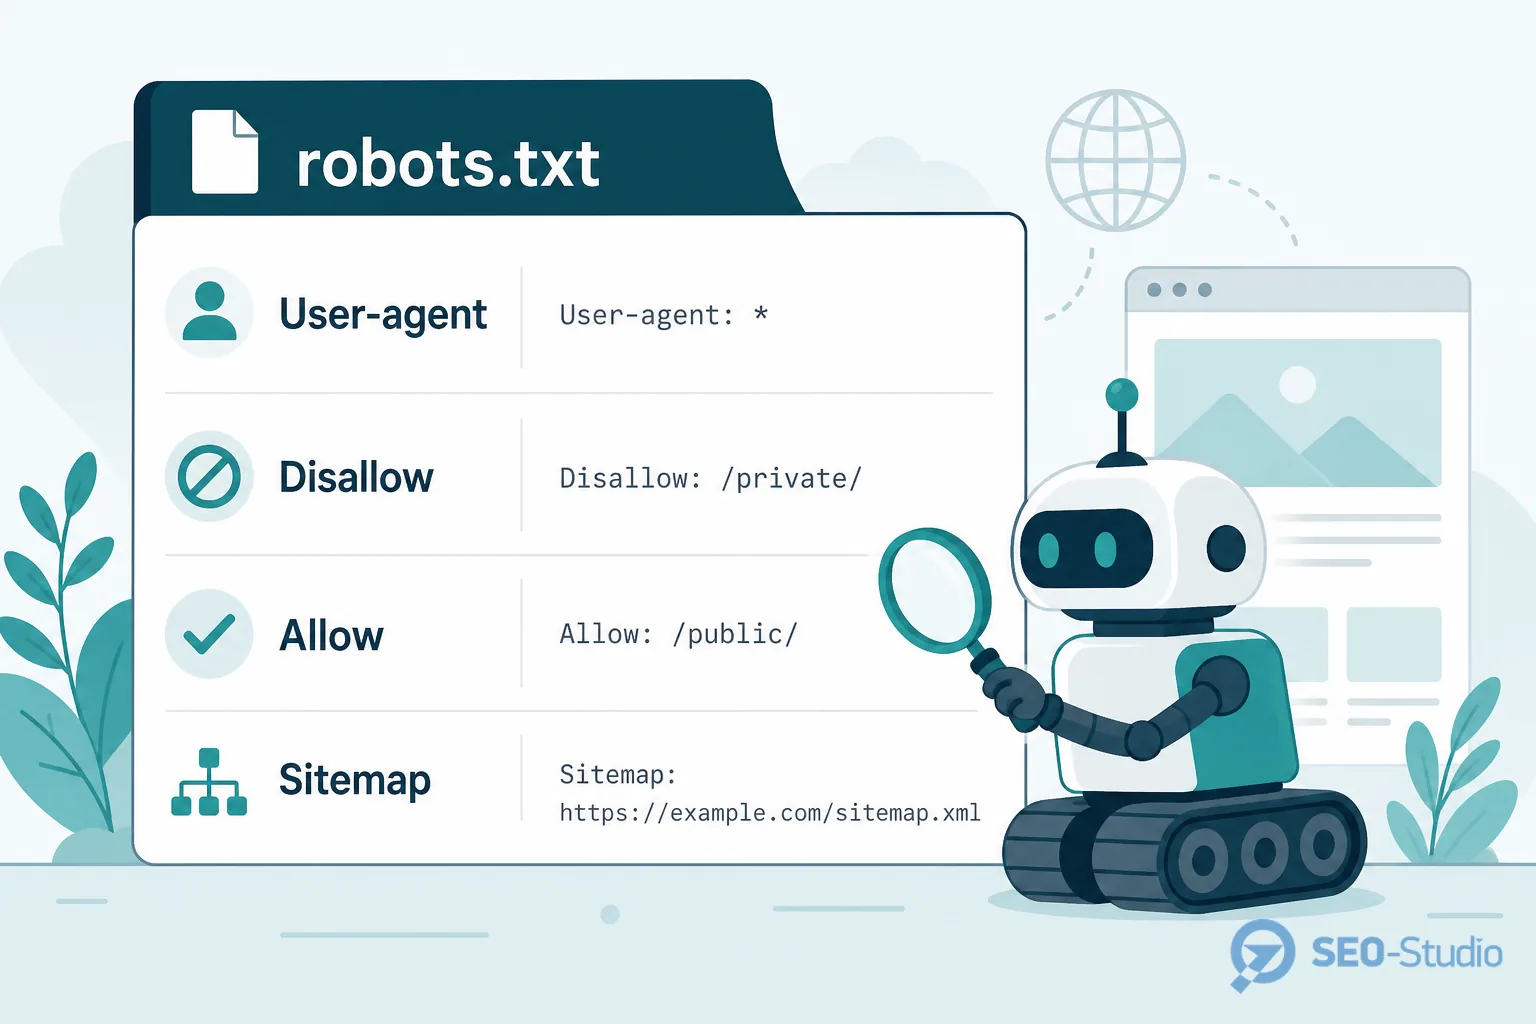
robots.txt — текстовий файл у корені домену, який підказує краулерам, що можна сканувати. Офіційні правила в документації Google про robots.txt.
Мінімальний робочий шаблон для WordPress:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/sitemap_index.xml- Кожен
User-agentпочинає новий блок правил. Disallowзабороняє префікс шляху. Порожній Disallow нічого не блокує.Allowзвужує Disallow — корисно для admin-ajax і окремих підшляхів.- Регістр і слеші важливі.
/pageі/page/— різні правила.
Файл має віддаватися з HTTP 200 і типом text/plain. Редірект з www на non-www не повинен ламати шлях до robots.txt.
Disallow проти noindex і crawl budget
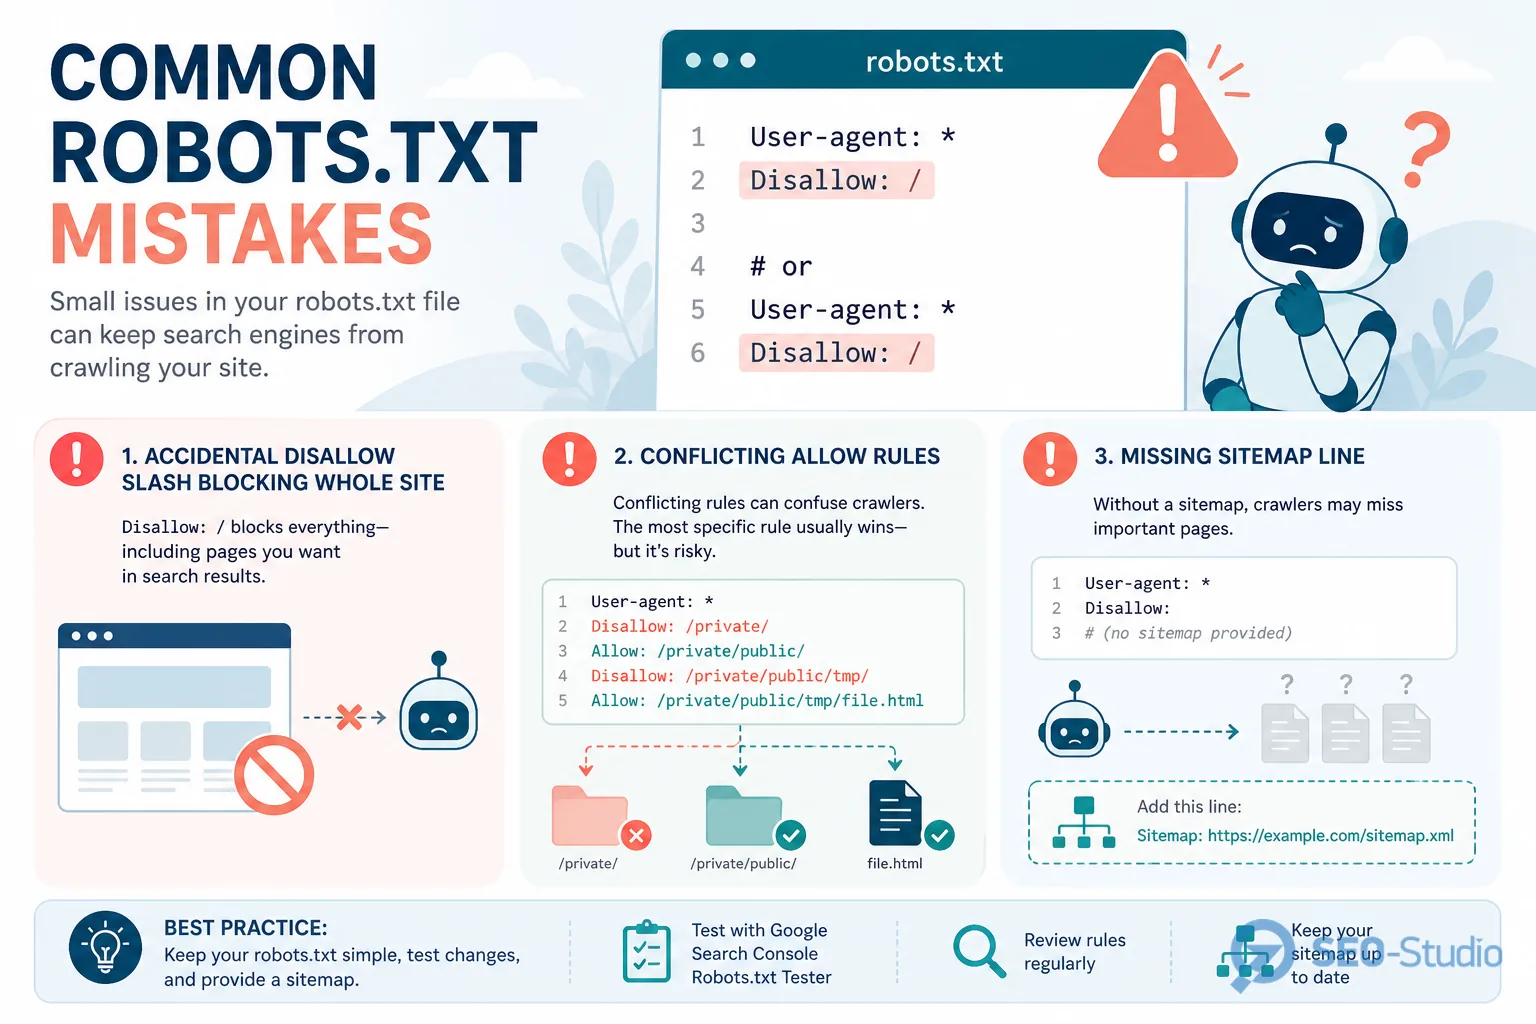
Найчастіша плутанина. Disallow каже «не заходь сканувати», але не гарантує видалення з індексу. noindex у HTML/meta каже «не показуй у видачі», але бот має побачити сторінку. Детальніше про різницю noindex і robots.txt.
- Закрили noindex-сторінку в Disallow — Google може не прочитати директиву й тримати URL у видачі.
- Сподіваєтесь, що Disallow «зекономить» crawl budget — бот часто все одно витрачає обхід на перевірку, а сторінка лишається в індексі.
- Блокуєте CSS/JS (
/wp-content/,/_next/static/) — ламається рендер і індексація SPA. - Дублюєте суперечливі правила для різних user-agent без тесту.
- Забули прибрати Disallow зі staging після переносу на прод.
Правильна схема для службових URL. Спочатку дозволити сканування, поставити noindex у шаблоні, потім за потреби обмежити лише те, що точно не має потрапляти в індекс і не потребує перевірки.
Перевірка в Search Console
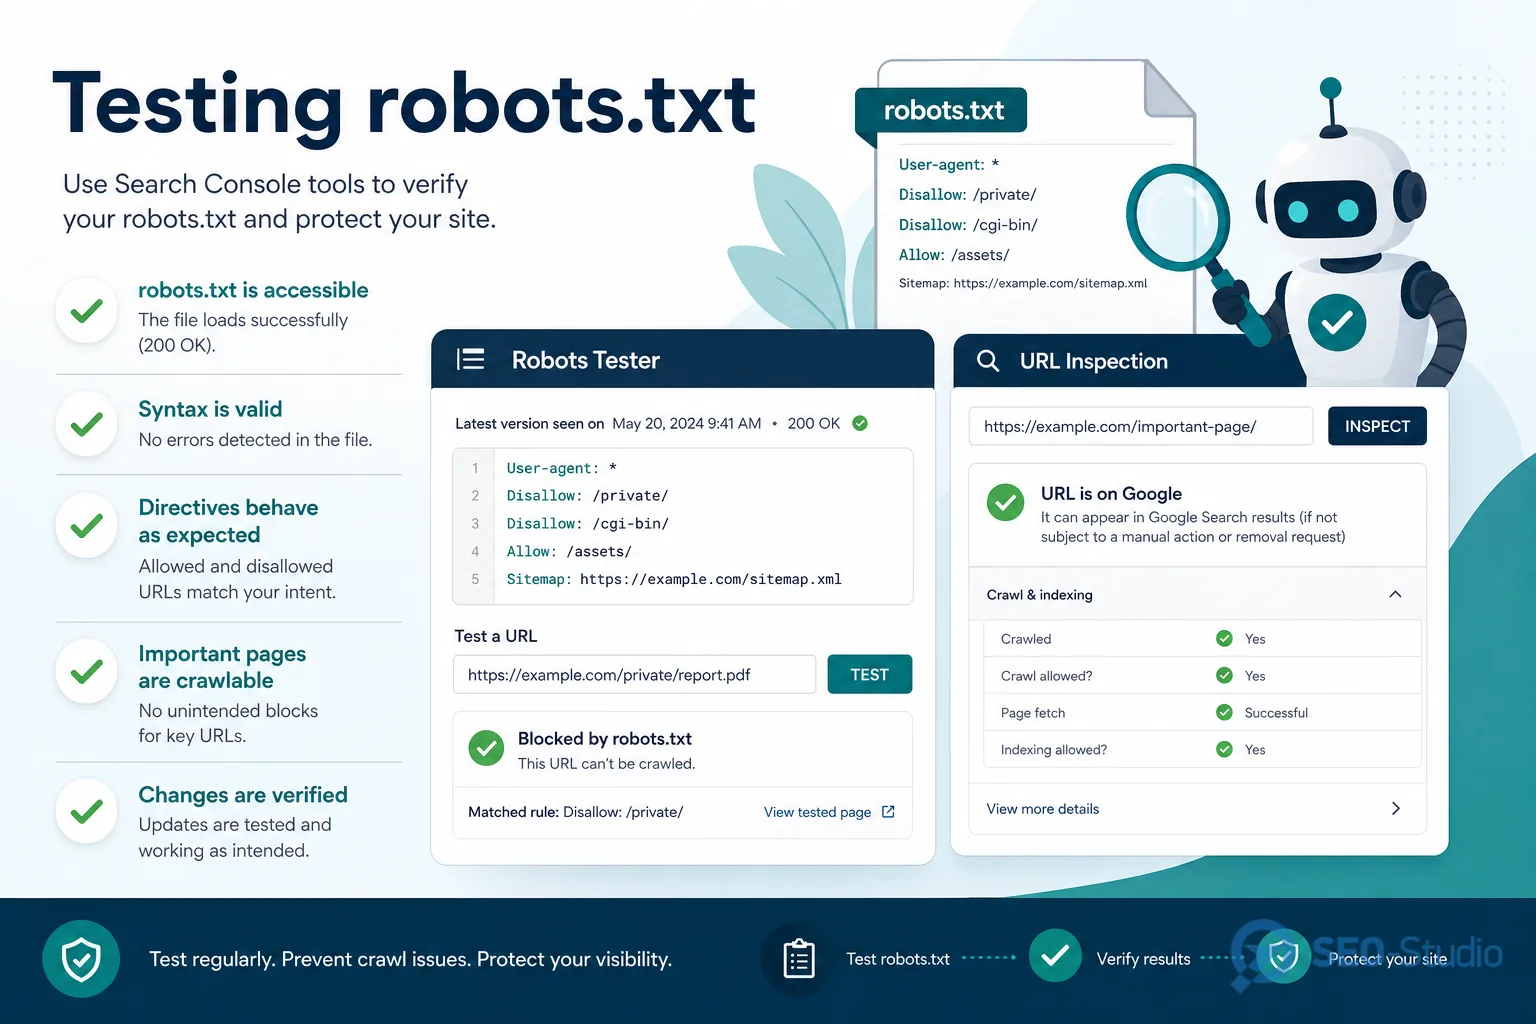
Після кожної зміни robots.txt перевіряйте не «в цілому ок», а конкретні URL.
- Відкрийте тестер robots.txt у Search Console. Подайте шляхи головної, категорій, sitemap, wp-admin.
- У URL Inspection перевірте «Page fetch» і «Indexing allowed?» для еталонних сторінок.
- У звіті Page indexing шукайте «Blocked by robots.txt» для важливих шаблонів.
- Звірте live-версію файлу (
curl -I https://site/robots.txt) з тим, що редагували в CMS/CDN. - Якщо є кеш CDN — скиньте його після правки, інакше Google бачить стару версію.
Рядок Sitemap і пріоритети обходу
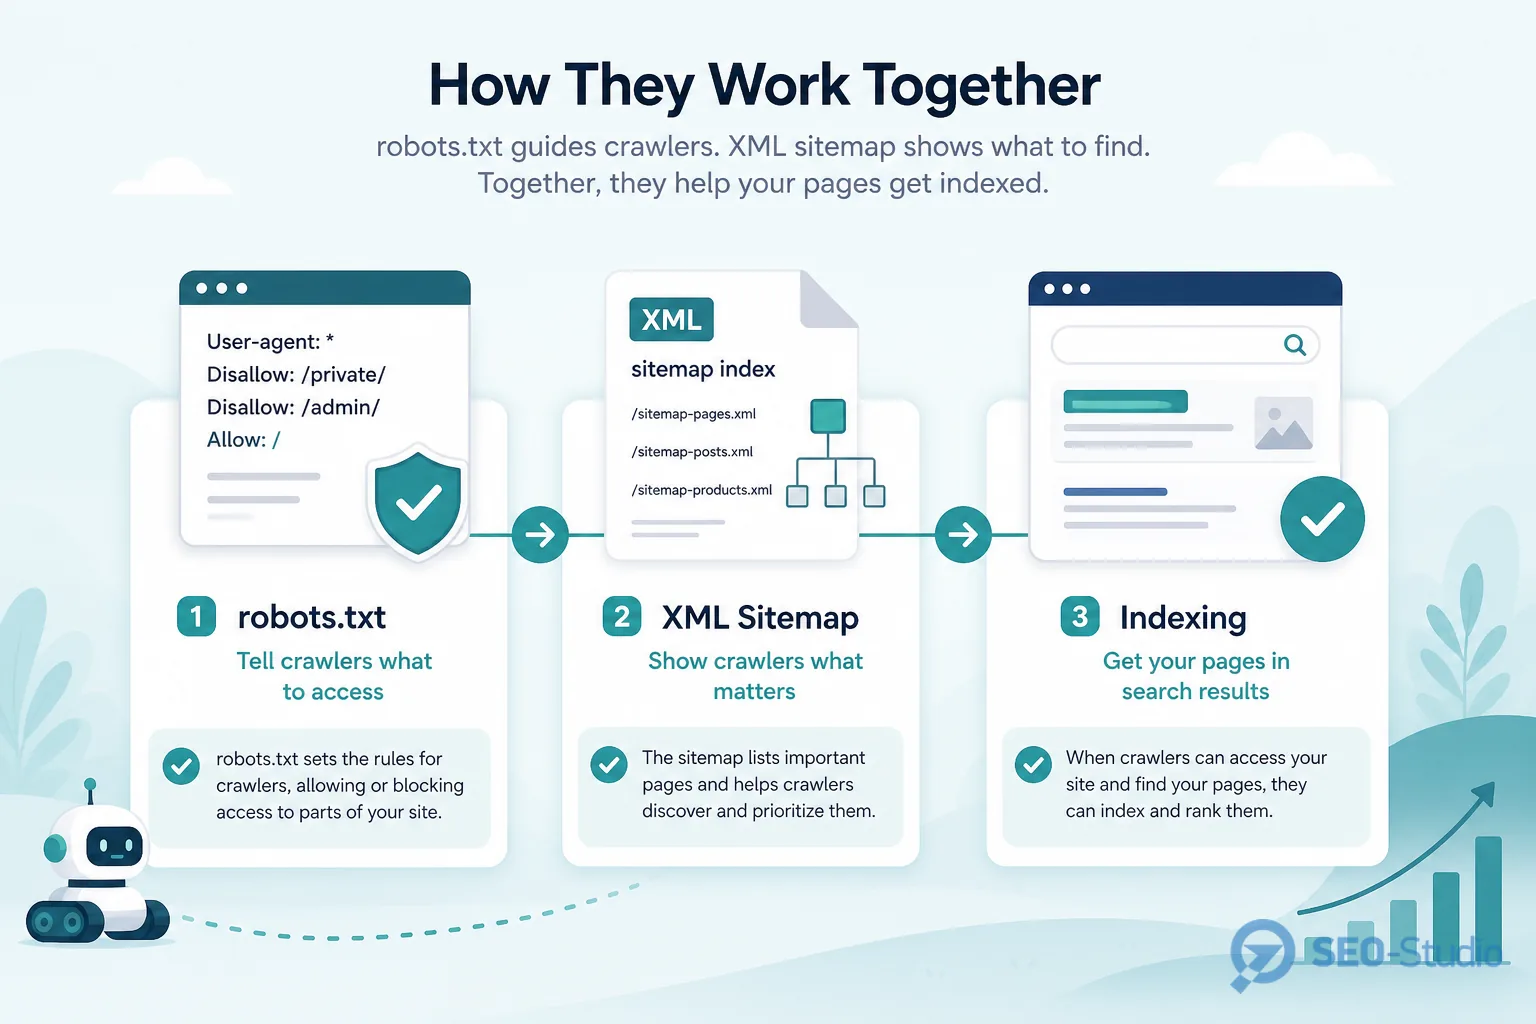
Директива Sitemap: вказує на XML-карту сайту. Вона не замінює внутрішні посилання, але прискорює знаходження карти після міграцій.
- Вказуйте абсолютний URL з https і правильним доменом (www чи без).
- Для мультимовних сайтів — індексну sitemap або окремі рядки на кожну мову.
- Не додавайте в sitemap URL, які закриті Disallow — сигнали суперечать одне одному.
- Після великих релізів перевірте, що нова sitemap доступна і не повертає 404.
Висновок
robots.txt керує скануванням, а не індексацією напряму. Не плутайте Disallow з noindex, не ріжте статику, тестуйте критичні URL у Search Console і тримайте Sitemap актуальною. Якщо потрібен аудит robots.txt разом ізі структурою сайту, команда SEO-Studio допоможе знайти конфлікти до того, як вони вдарять по індексації.