Чому access-логи для SEO, а не лише GSC
Log file analysis для SEO показує що реально відбувається на сервері коли боти і користувачі бʼять у URL. Search Console дає агрегати по URL і query, але не показує кожен hit, точний status-код, час відповіді nginx і повторні crawl одного URL за годину.
Різниця критична для e-commerce і великих каталогів. GSC може показати «URL indexed», але логи покажуть що Googlebot 400 разів за тиждень обходить фільтр з параметрами без жодного кліку. Або що після deploy у вівторок 18% Googlebot hits отримали 503.
- Факт crawl скільки разів Googlebot завантажив конкретний URL за тиждень, а не «чи був хоч раз».
- Waste фільтри, параметри, пагінація, tag-архіви без цінності для індексації.
- 5xx/429 моменти коли бот отримав помилку сервера і пішов без індексації.
- Інші боти Ahrefs, Semrush, підозрілі scrapers окремо від Googlebot для rate limit.
- Timing чи crawl spike співпав з релізом, DDoS або cron-завданням.
Технічний контекст crawl budget описаний у Managing crawl budget. Практичний аудит часто стартує в технічному SEO. Логи доповнюють crawl Screaming Frog тим, що показують реальну поведінку Googlebot, а не лише те що доступно без JS.
Коли логи обовʼязкові. Сайт 10k+ URL, faceted navigation, CDN перед origin, часті deploy, підозра на crawl waste або падіння індексації без очевидних помилок у GSC Coverage.
Які поля дивитись у nginx access-логах
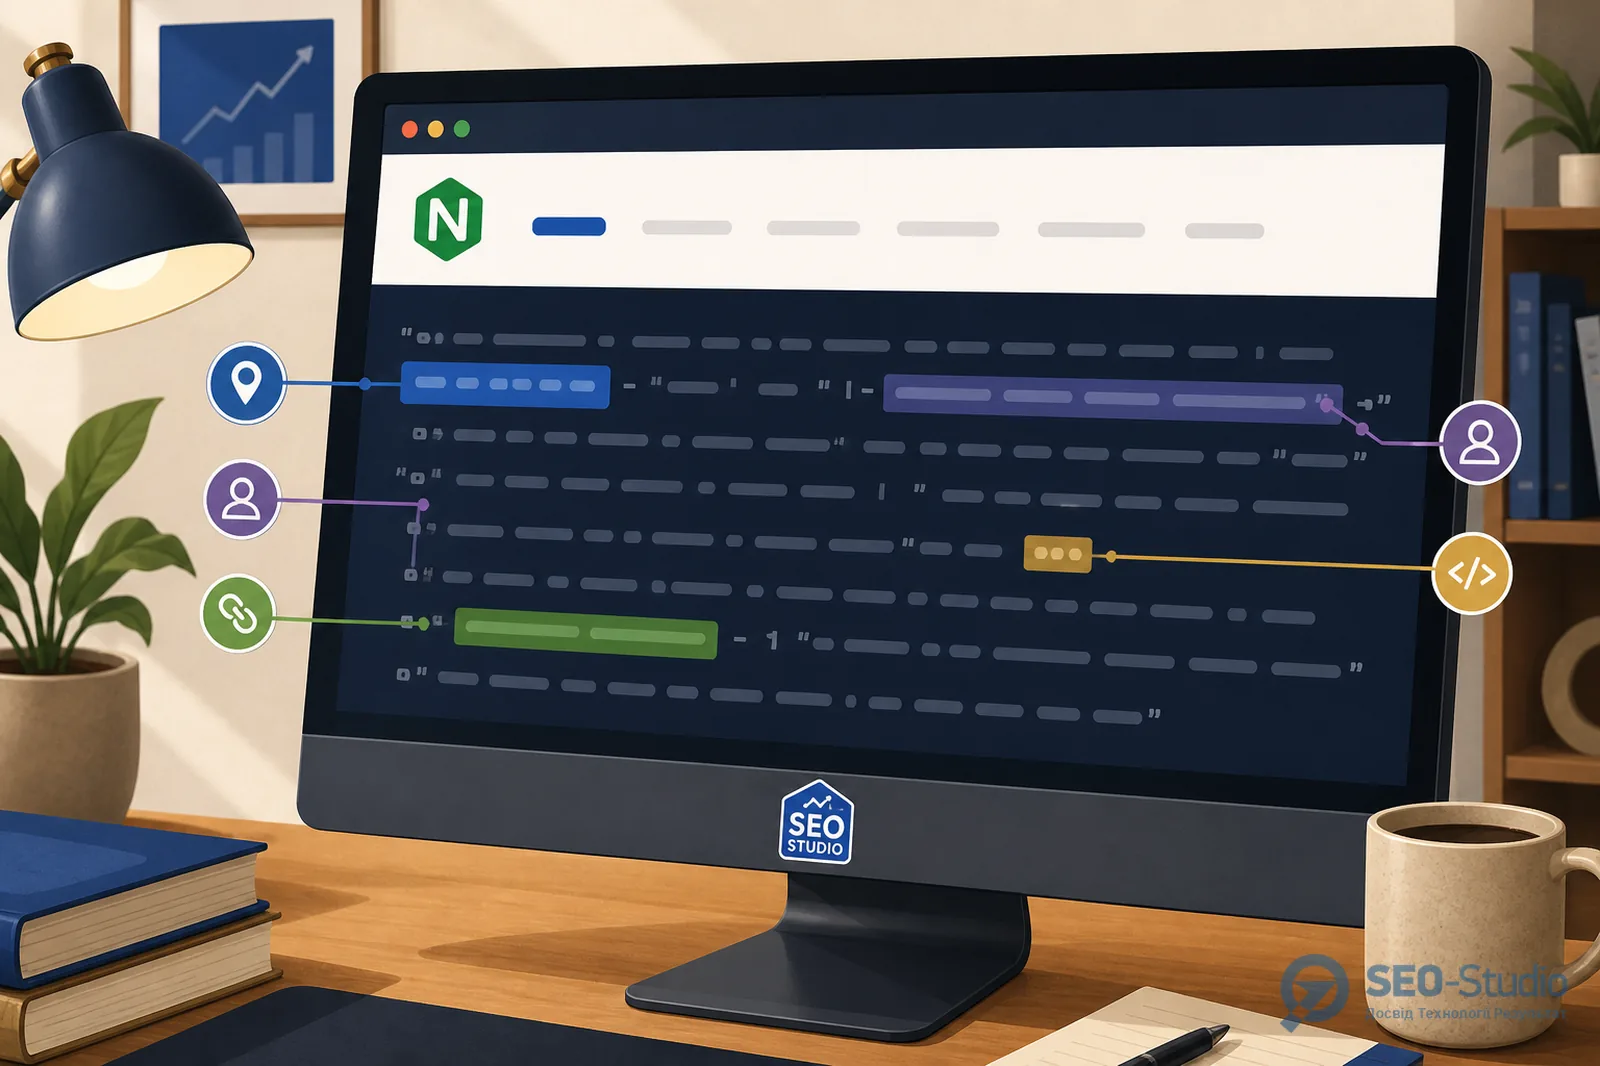
Стандартний combined log у ngx_http_log_module містить $remote_addr, $time_local, $request, $status, $body_bytes_sent, $http_referer, $http_user_agent. Для SEO-аналізу мінімальний набір полів
- request метод + URI + протокол (GET /category/page/ HTTP/1.1). Витягніть path без query для групування або path+query для faceted URL.
- status 200/301/404/500 і частота по URL. Окремо рахуйте 3xx chains.
- user-agent класифікація бота. Googlebot Smartphone vs Googlebot для mobile-first.
- time_local розподіл crawl по годинах і днях (пік на deploy?).
- body_bytes_sent 0 байт на 200 часто означає порожню або soft-404 сторінку.
Швидкий старт без ELK. На VPS з nginx достатньо awk і grep. Приклад топ URL для Googlebot за 7 днів
zgrep -h Googlebot access.log* | awk '{print $7}' | sort | uniq -c | sort -rn | head -30Для status breakdown додайте поле $9. Якщо логи на CDN (Cloudflare, Fastly), експортуйте edge logs окремо і не змішуйте з origin без dedupe по timestamp+URL.
Хак на замітку. Зберігайте сирі логи 14–30 днів. Тижневий зріз часто достатній для першого аудиту, але deploy у середу без контексту дати зібʼє WoW порівняння. Ротація logrotate має зберігати .gz архіви мінімум два цикли.
Класифікація ботів і bot hits
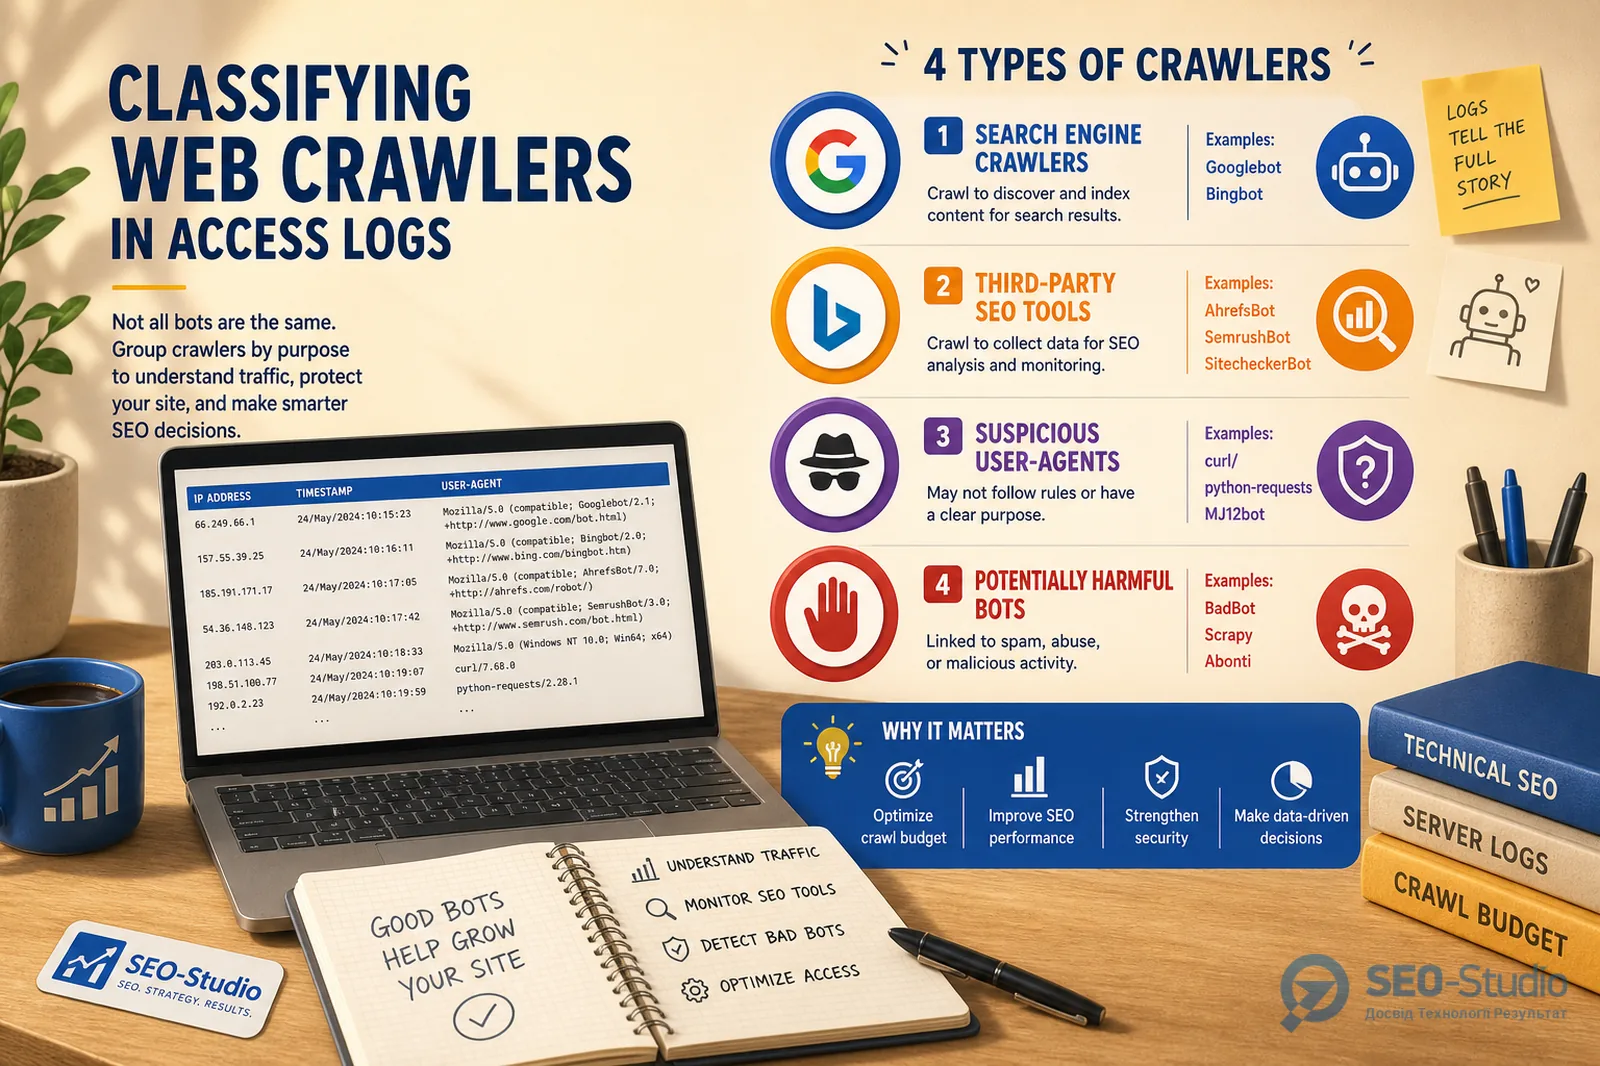
Не кожен рядок зі словом bot це Google. Зведіть user-agent у групи
| Група | Приклади | Що робити |
|---|---|---|
| Googlebot | Googlebot, Googlebot-Image, Googlebot-Video | Основний crawl budget, пріоритет fixes |
| Bing / інші SE | bingbot, Applebot, YandexBot | Моніторинг, менший пріоритет |
| SEO tools | AhrefsBot, SemrushBot, MJ12bot | Rate limit якщо навантажують origin |
| Scrapers | порожній UA, підозрілі IP, fake Googlebot | Firewall / robots / 403 за політикою |
Reverse DNS для Googlebot варто перевіряти на великих вибірках (host має закінчуватись на googlebot.com), але для щотижневого SEO-звіту достатньо стабільного regex по user-agent. Fake Googlebot часто має IP поза діапазонами Google і не проходить reverse lookup.
Ризик. Блокування всіх «незнайомих» ботів може відрізати корисні моніторинги (UptimeRobot, PageSpeed). Краще rate limit 10 req/s для SEO tools, ніж повний 403. Порівняйте частку Googlebot hits vs інших ботів. Якщо AhrefsBot = 40% трафіку origin, проблема не в crawl budget Google, а в агресивному краулінгу інструментів.
Crawl budget і waste URL
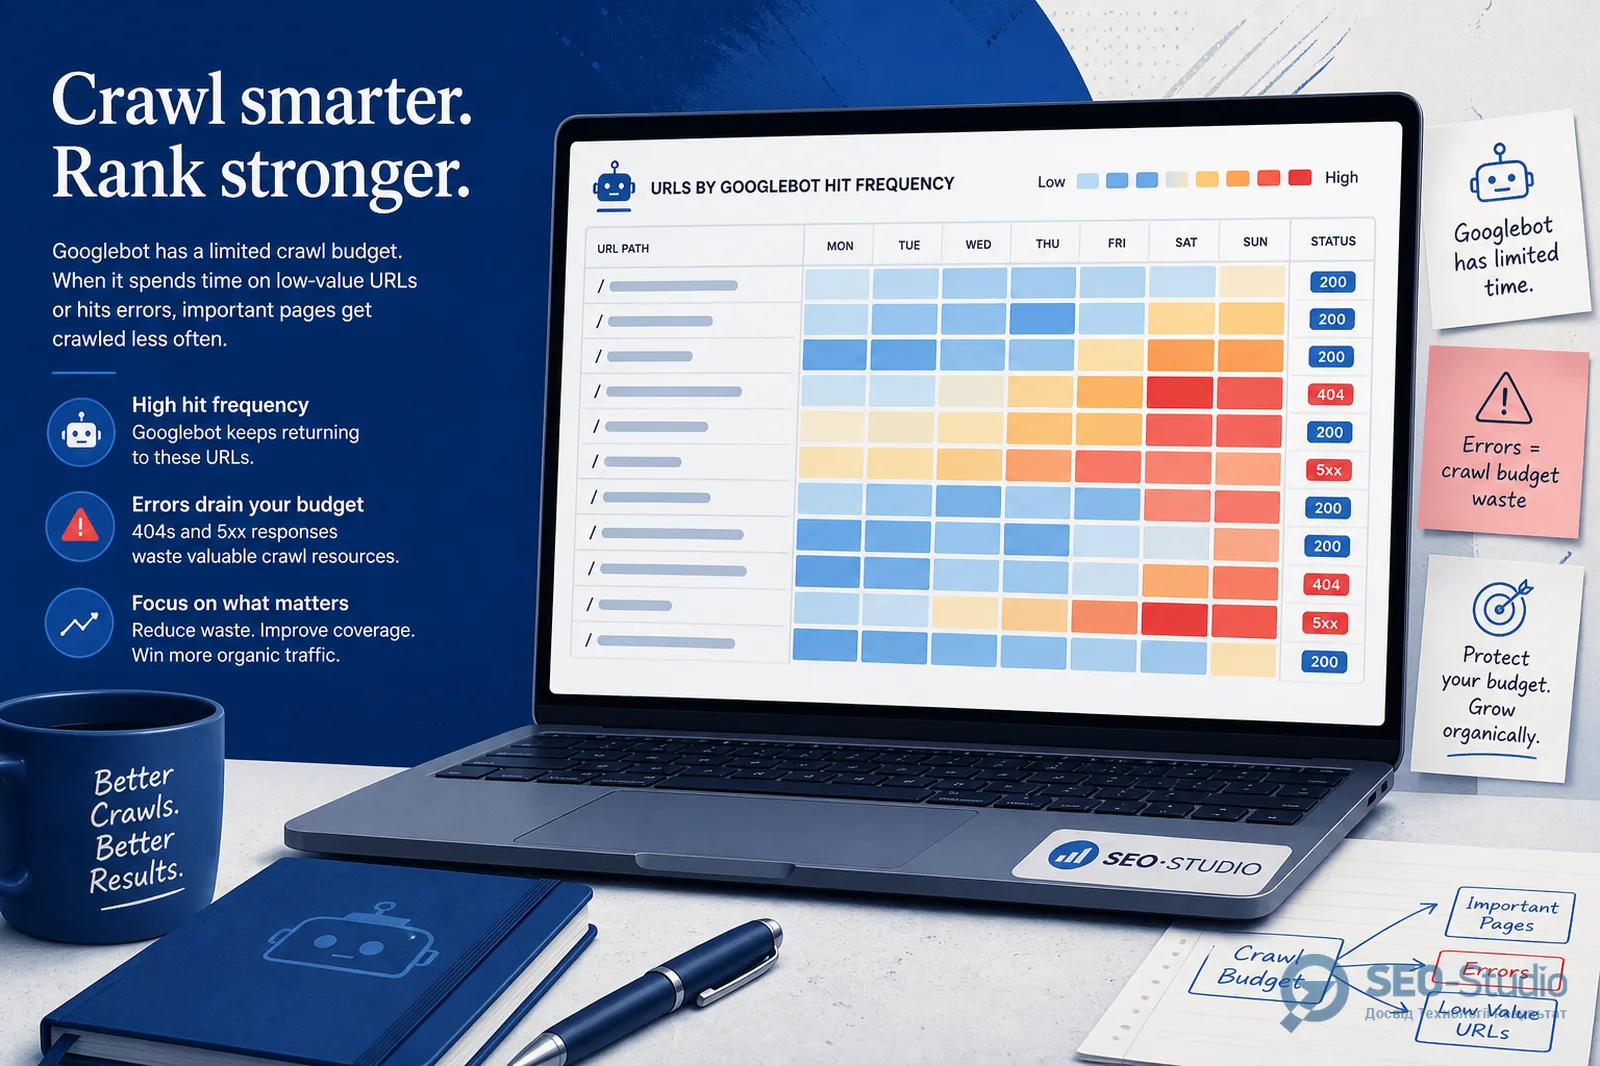
Топ-20 URL за Googlebot hits за 7 днів майже завжди показує куди йде бюджет. Типові waste-патерни на e-commerce і контент-сайтах
- Faceted navigation з комбінаціями фільтрів без попиту (?brand=…&price=…).
- Internal search (?s=, /search?q=) з індексацією і crawl.
- Пагінація /page/47/ без canonical на себе або на page/1.
- 404/410 які бот обходить знову через внутрішні посилання або sitemap.
- Redirect chains 301→301→200 на money-URL.
- Calendar/tag archives з тисячами thin URL.
- Staging або preview URL без noindex потрапили в production crawl.
Зіставте log hits з GSC Coverage і sitemap. URL з сотнями hits і 0 impressions у GSC за той же період часто кандидат на noindex, canonical на батьківську категорію або видалення з sitemap.
Приклад верифікації. Категорія з параметром filter_color=red має 890 Googlebot hits за тиждень, 0 кліків у GSC. Fix: noindex,follow на параметричні URL або AJAX-фільтри без окремого URL.
Після fix повторіть зріз логів через 14 днів. Якщо hits на waste URL не впали, перевірте internal links, XML sitemap і hreflang.
Швидка перевірка access-логів
Чекліст на замітку (15 хвилин). Зробіть зараз перед щотижневим SEO-sync
- Зніміть 7 днів access.log (або rotate archive .gz) з production, не staging.
- Порахуйте Googlebot hits по status (200 vs 301 vs 404 vs 5xx). Якщо 5xx > 1% hits, пріоритет P0.
- Топ-30 URL за hits. Позначте фільтри, параметри, пагінацію окремим кольором у таблиці.
- Знайдіть URL з hits але без кліків і impressions у GSC за той же період.
- Перевірте чи deploy/spike crawl співпав з 5xx або 429 (rate limit).
- Порівняйте mobile vs desktop Googlebot якщо є окремі UA в логах.
- Зафіксуйте 3 URL-fix пріоритети в backlog з owner і очікуваним впливом на crawl.
- Експортуйте таблицю в Google Sheets для WoW порівняння наступного тижня.
Якщо немає доступу до серверних логів, попросіть CDN export (Cloudflare Logpush, AWS ALB logs). Без origin logs ви не побачите 5xx від PHP-FPM, лише edge status.
Weekly workflow. Понеділок знімаєте логи, вівторок top-30 + GSC overlap, середа backlog fixes, через 14 днів re-check. Такий цикл тримає crawl budget під контролем без щомісячного «великого аудиту».
Типові помилки log analysis
- Дивитись лише унікальні IP замість hits по URL (один IP може crawl 10k URL).
- Ігнорувати 304/302 як «не проблема» (302 chains і loop їдять budget).
- Змішувати CDN edge logs і origin без dedupe (подвоєні hits).
- Робити висновки з 1 дня після релізу (потрібен мінімум 7 днів).
- Блокувати всі сторонні боти замість rate limit.
- Не зіставляти логи з GSC (hits без impressions = waste).
- Забувати про log sampling на великих CDN (множте на коефіцієнт sample rate).
Verification loop. Fix → wait 7–14 days → re-run top URL report → confirm GSC Coverage stable or improved. Документуйте baseline hits до fix, інакше клієнт не побачить прогрес.
Tooling. Screaming Frog Log File Analyser імпортує nginx/apache logs і будує bot hit reports. GoAccess дає real-time dashboard на VPS. ELK stack для enterprise, але overkill до 100k hits/day.
Для WordPress + Cloudflare комбінуйте CF Analytics bot traffic з origin logs. Якщо CF показує 10k Googlebot/day, а origin 2k, cache HIT не потрапляє в origin log і картина неповна.
Висновок
Log file analysis для SEO це швидкий спосіб побачити crawl waste, bot hits і помилки сервера до того як вони зʼїдять бюджет і індексацію. Почніть з Googlebot + status + top URL за тиждень, зіставте з GSC і sitemap, зафіксуйте три пріоритетні fixes.
На малих сайтах до 500 URL логи рідко дають сюрпризи. На каталогах і marketplace вони часто показують швидші wins ніж новий контент. Інструменти на кшталт Screaming Frog Log File Analyser, GoAccess або ELK stack прискорюють звіти, але базовий awk/grep на VPS уже дає actionable дані без ліцензій.
Потрібен технічний аудит з логами команда SEO-Studio допоможе в рамках SEO-послуг.